术语
基础术语
| 隐藏维度 | d_model / hidden_size / n_embd |
《Attention Is All You Need》习惯用 d_model,强调这是“整个模型的统一维度”。而 BERT 等早期预训练模型沿用了 RNN 时代的命名,把所有内部状态尺寸都叫 hidden_size。GPT-2 的开源代码则用 n_embd(number of embedding dimensions) |
| 参数 | Parameters 整体参数集合:希腊字母 θ(theta)或 Θ • 有时也用粗体 W 一并泛指所有参数(大模型语境下常见)。 |
参数是所有权重、偏置以及各类可学习因子的统称。 输出 = 权重 × 输入 + 偏置。 为了训练稳定和推理高效,许多大模型(如 LLaMA 系列、PaLM 等)在设计时,就 直接取消了所有线性层的偏置项 。 当 b = 0 时,模型中就只剩下权重 W 了。此时,所有权重就是全部参数。 |
| 权重 | Weights 权重矩阵 :大写粗体 W(常见于线性层、卷积层等) • 单个权重:小写 w,带下标表示连接,如 表示从第 i 个输入到第 j 个输出的权重。 |
线性变换中的乘法系数 ,表示前一层神经元对后一层神经元的 连接强度。例如,一个全连接层的计算 y = Wx + b 中,W 就是权重,它直接作用于输入数据。 |
| dense 层 / 全连接层 | 每个输出神经元都和 所有 输入神经元有连接,这种“全互连”的模式就叫“密集连接”(Dense Connectivity),对应的权重矩阵也是密集的(非稀疏矩阵)。FFN 本质上就是两个 Dense 层夹一个激活函数。 | |
| 共享专家 | Dense Expert / Shared Expert | 有的 MoE 模型会专门留出一个 被所有 token 共享的专家,它不走路由,永远激活 |
| 前馈网络 | FFN/MLP | FFN:前馈网络,表示没有循环结构的前向网络。 MLP:多层感知机,强调它由全连接层 + 激活函数构成(通常是两层),是深度学习通用术语。 |
| 门控前馈网络 | Gated FFN / SwiGLU FFN / GLU‑based FFN | Gated FFN:使用了门控机制(两路线性投影 + 元素乘)的 FFN。 SwiGLU FFN / GLU‑based FFN:具体实现常使用 SwiGLU 这类 GLU 变体,论文中直接用激活函数来指代整个结构。 |
| 嵌入层 | Input Embedding / Token Embedding / Word Embedding | Input Embedding:模型接收的初始向量表示。 Token Embedding:针对 token 的嵌入,更强调分词后的基本单元。 Word Embedding:NLP 中沿用“词嵌入”的说法,即使实际对象已经是子词 token。 |
| 专家 | Expert / FFN | 在 MoE 层中,每个“专家”实际上就是一个前馈网络(FFN)。叫它“专家”是希望每个 FFN 能专门处理某一类模式,形成“术业有专攻”的效果。 |
| 门控网络 | Gating Network / Router | Gating Network:继承自 Mixture of Experts 的经典术语,用 softmax 产生权重,像一道“门”控制信息去往哪个专家。 Router:后续工作(Switch Transformer 等)更倾向称其为路由器,强调它做出离散的“路由”决定,把 token 发往不同专家。 |
| 负载均衡损失 | Load Balancing Loss / Auxiliary Loss | Load Balancing Loss:目标很明确,就是让各专家的 token 数量尽量均匀,避免某些专家过载。 Auxiliary Loss:相对于语言建模等主任务损失,它是“辅助”损失。MoE 的辅助损失通常由负载均衡项及 router z‑loss 组成,因此常统称辅助损失。 |
| Logits | 送入 Softmax 之前的原始数值就叫 Logits | |
| 激活值 | 激活值泛指前向传播过程中,所有 非权重、非输入 的中间特征张量(即为了算反向传播必须暂存的中间结果) | |
| 梯度 | 激活值 属于 前向传播 的产物,而 梯度 属于 反向传播 的产物。 以损失函数为起点,利用链式法则从输出层向输入层逆向推导出的偏导数(包括对激活值的梯度 和对权重的梯度 ) |
学习率
在训练神经网络时,我们通过梯度下降法来更新模型参数,目标是找到让损失函数 最小的参数 。更新公式为:其中的 η 就是学习率。
- 作用 :它控制了每次参数更新时,在梯度方向上迈出的 步长 有多大。
- 直观理解:可以把寻找最低点想象成“摸着石头下山”。梯度是当前最陡的下山方向,而学习率是你“每一步迈出多远”。步子太小,下山极慢;步子太大,可能直接跨过山谷,甚至越走越高(损失爆炸)。
如何设置学习率?
设置学习率没有一成不变的固定值,但有一套成熟的实践策略。通常从 选择初始值 和设计衰减计划 两个维度来考虑。
1. 选择一个合适的初始学习率
- 通用起点:
- 对于 SGD(随机梯度下降):通常从 0.1 或 0.01 开始尝试。
- 对于 Adam/AdamW 等自适应优化器:由于其内部会为每个参数自动调整有效步长,标准初始学习率常设为 3e-4(如 Transformer 原论文)、1e-3 或 1e-4。在很多视觉任务中,1e-3 是 Adam 的默认好起点。
- 学习率范围测试(LR Range Test):
这是一种很实用的技巧。让模型从极小的学习率(如 1e-7)开始训练,每个 batch 后指数级增大学习率,同时记录损失的变化。画出“学习率 - 损失”曲线,通常会看到损失先下降,到达某个点后开始反弹或爆炸。最优初始学习率 往往选择在损失下降最快的区间,或者比最低点对应的学习率小 10 倍左右。这能帮你科学地找到一个任务专属的好起点。 - 依据批次大小调整 :
经验上,当批次大小(Batch Size)成倍增加时,学习率也应按比例线性增加(Linear Scaling Rule),以保持参数更新的方差基本稳定。例如,批次从 128 增到 1024(8 倍),学习率也可以相应增加 8 倍。
2. 设计学习率的衰减计划
在整个训练过程中,固定学习率通常不是最优的。常见策略是让学习率从初始值逐步衰减,以精细收敛。
- 分步衰减(Step Decay):每隔一定轮数(Epoch),将学习率乘以一个衰减因子(如 0.1)。比如初始 0.1,每 30 轮降为上一阶段的 1 /10。简单粗暴,但很有效。
- 余弦退火(Cosine Annealing):学习率按余弦曲线平滑地从初始值降至 0(或一个极小值)。这能让训练后期参数在极小步长下平滑地滑入较优的平坦区域,是目前最常用的方案之一。
- 预热(Warmup):训练的最初几千步,学习率不是从初始值开始,而是从 0 线性地(或缓慢地)增加到设定的初始值。这对于用 Adam 训练 Transformer、大模型等至关重要,可以避免模型在初始阶段因梯度方差大而发生剧烈震荡,让训练更稳定。
- 自适应优化器自带衰减:Adam 等优化器本身就会根据梯度的一阶 / 二阶矩动态调整每个参数的有效学习率,通常能起到类似衰减的效果。但实践中,对 Adam 再配合余弦退火等外部衰减计划,往往能获得更好性能。
3. 实践中的黄金法则
- 默认起步:Transformer/ 大模型用 AdamW + 3e-4 或 1e-4,并务必加上 Warmup。
- 粗调搜索:在对数尺度上粗搜,例如 [1e-4, 3e-4, 1e-3, 3e-3],运行少量轮数观察验证集曲线。
- 精调:用 LR Range Test 锁定最佳初始值,再配合余弦退火计划。
- 监控行为:
- 损失出现 NaN 或 Inf:学习率过大,立刻降低。
- 损失 长期停滞不降:可能学习率过小,或已进入平原,可尝试增大或重启学习率(如 Warm Restart)。
- 损失 剧烈震荡:减小学习率或增大批次。
简单总结,学习率是控制学习步长的旋钮,先用 范围测试 找到合理起点,再用 预热 + 余弦退火 规划其下降路径,就能在绝大多数任务中获得稳定且高性能的训练结果。
各种 Loss
1. 语言建模损失(主损失)
这就是模型的“主任务”,目的是让模型学会预测下一个词。
- 目的:让模型学会语言规律、知识和推理。
- 计算方式 :给定输入序列,模型预测每个位置的下一个词的概率分布,然后和真实的词比较,计算 交叉熵损失。
- 交叉熵损失(Cross-Entropy Loss):
- 公式直观理解 :
Loss = -log(模型对“正确词”的预测概率)模型越确定正确答案,概率越接近 1,-log(1)=0,损失越小;越猜不准,概率接近 0,-log(0)趋近无穷大,损失越大。 - 在 MoE 中:这个损失会正常反向传播,同时更新自注意力参数、门控网络参数和所有被激活的专家参数。它是模型学习能力的根本来源。
2. 负载均衡损失
强制让每个专家在大量训练步中,被分配到的 token 数量大致相等。需要理解两个概念:“模型觉得该分给谁”和“实际分给了谁”。
对于一批输入,经过门控网络后,每个 token 都会对每个专家产生一个 门控概率 (softmax 之后的值,表示模型觉得这个 token 有多大比例应该给这个专家)。然后我们会根据这个概率选择 Top- k 专家,进行 硬分配。
- (专家 i 的平均门控概率):在这一批所有 token 中,门控网络为专家 i 输出的 概率的平均值。代表模型“愿意”分配给专家 i 的比例。
- (专家 i 的实际分配比例):在这一批所有 token 中,实际上被硬性分配给专家 i 的 token 数量占比。注意,这是离散的,要么选了,要么没选。
负载均衡损失就是用来惩罚 和 之间的不匹配,希望两者尽量一致,且接近均匀分布。
最常用的公式来自 Switch Transformer(N= 专家总数):直观拆解:
- 我们希望的情况是:每个专家处理
1/N的 token,即= 1/N;同时门控概率平均也是1/N,即= 1/N。此时乘积 ,求和后乘以 N,损失为 。 - 如果出现极端不均,例如专家 1 处理所有 token(),其他专家为 0,那么乘积只有一项为 1,求和为 1,乘以 N 后损失为 N,远大于 1。模型为了降低这个损失,就必须让分配更均匀。
- 注意:这个损失 同时约束 了分配比例 和门控概率 。如果只是分配均匀但门控概率很极端(比如 均匀,但 却集中于某个专家),损失也会比较大。
最终,总损失是这个样子: 其中 α 是一个很小的超参数(比如 0.01),防止辅助损失过度干扰主任务。
3. Z-Loss(路由器 Logits 稳定性损失)
这个损失更细致了,是为了 让门控网络输出的原始分数(logits,未经 softmax)不要太大。
- 目的:防止训练不稳定。如果门控 logits 数值非常大,会导致 softmax 后的概率极度集中,梯度消失或爆炸,整个训练崩溃。Z-loss 强制拉低 logits,让门控更“犹豫”,输出更平稳。
- 计算方式 :
对每个 token,门控网络在 softmax 之前会输出一组 。Z-loss 就是简单地对这些 logits 求 平方和 ,然后取平均(或者最大值): 实际上,常见实现就是mean(logsumexp(z))^2,本质是惩罚过大的 logits。 - 效果:加上这个损失后,logits 会倾向于变小,门控概率分布更平滑,专家分配更稳定,训练曲线更好看。
总结:MoE 训练中的损失全景
| 损失名称 | 目的 | 计算对象 | 典型权重 |
|---|---|---|---|
| 语言建模损失 | 学习语言本身 | 下一个词的预测概率 | 1.0(主导) |
| 负载均衡损失 | 让各专家被分配 token 数均匀 | 分配比例 f_i 与门控概率 P_i 的乘积和 |
0.01 左右 |
| Z-Loss | 稳定门控训练,防止 logits 过大 | 门控 logits 的 logsumexp 的平方 | 0.001 左右 |
训练时,这些损失是加在一起反向传播的。 主损失驱动学习,辅助损失像温柔的“约束力”,引导门控网络做出既聪明又均衡的路由决策。这种均衡,正是大规模分布式训练可以高效并行的关键——因为每个专家的计算量可预测,通信模式整齐。
Softmax
1. Softmax 的核心作用:把任意实数变成概率
Softmax 本质上是一个 归一化指数函数。它做三件事:
- 指数化 (exp):把输入的每个数都变成正数。这保证了 输出不会是负数。
- 求和:把所有指数化后的结果加起来,得到一个总和。
- 归一化:用每个指数化后的值去除以这个总和。
这样一来,所有输出都在 (0,1) 之间,并且加起来严格等于 1。这就成了一个完美的 概率分布。
类比:考试成绩换算
假设你三科原始分是:数学 120,语文 90,英语 60(满分 150)。没法直接用,因为总分不是 1。
Softmax 就像一个换算公式,它不看绝对分数,而是看你的 相对优势 。它会输出类似:数学 0.8,语文 0.15,英语 0.05。这意味着“模型认为,选择‘数学’的概率是 80%”。 分数最高的经过 Softmax 后会更突出,低的会被进一步压缩,而且所有概率加起来是 100%。
2. 它用在哪些地方?
应用一:注意力机制中的“权重计算器”
这是我们之前讲自注意力时,生成权重的那一步。
- 位置:在计算了查询 Q 和键 K 的点积,得到原始的相关性分数(logits)之后。
- 作用:将这些分数转化为总和为 1 的注意力权重。
- 直观理解:对于“爱”这个词,它和“我”、“你”、“吃”的相关性分数可能是[3.1, 0.2, 1.5]。经过 Softmax 后变成[0.75, 0.04, 0.21]。
- 这意味着“爱”应该把 75% 的注意力放在“我”上,21% 放在“吃”上,4% 放在“你”上。
- Softmax 确保了权重和为 1,从而可以对值向量 V 做一个 合理的加权平均。没有它,注意力机制就崩塌了。
应用二:语言模型头(LM Head)中的“词预测器”
这是我们讲交叉熵损失时的前提步骤。
- 位置:在模型最后一层输出 logits 之后,计算损失之前。
- 作用:将模型对所有词的原始分数,转化为一个在所有候选词上的概率分布。
- 直观理解:模型输出了三个候选词的 logits
[2.0, 1.0, 0.1],Softmax 后变成[0.659, 0.242, 0.099]。这直接告诉我们“模型认为下一个词是‘苹果’的概率为 65.9%”。交叉熵损失正是针对这个概率分布和真实答案来计算的。
应用三:MoE 门控网络(路由器)中的“专家分配器”
这是我们进入 MoE 主题后遇到的核心应用。
- 位置:在路由器(一个小型线性层)输出原始分数之后,决定将 token 发送给哪些专家之前。
- 作用:将路由器对各个专家的偏好分数,转化为一个概率分布。
- 直观理解:假设有 4 个专家,路由器的原始输出是
[1.2, 0.5, 4.0, -2.0]。经过 Softmax 后可能变成[0.05, 0.03, 0.90, 0.02]。- 这个概率分布表示:模型认为,这个 token 有 90% 的概率最适合专家 2 来处理。
- 这个概率分布,就是我们在 MoE 负载均衡损失里提到的
P_i(门控概率) 的来源。MoE 会据此进行 Top- K 选择(比如选概率最高的 1 个专家),并将 token 硬性派发过去。 - 负载均衡损失正是为了让这些
P_i在不同 token 间的平均值,尽量接近均匀分布,防止某个专家垄断。
3. 为什么 Softmax 比简单的“归一化”更好?
你可能会问:为什么不直接把原始分数除以总和来归一化?比如 [4, 2] 变成 [0.66, 0.33]?
关键在于 指数函数 exp() 的作用:
- 放大差异,使学习更容易:它能让大的值变得相对更大,小的值相对更小。
[4, 2]用简单归一化是[0.66, 0.33],差异 2 倍。但 Softmax(加上 exp 后)大约是[0.88, 0.12],差异被放大到 7 倍多。这让模型的“偏好”更清晰,梯度也更强。 - 保证非零概率:即使是最小的值,exp 之后也是正数,所以 Softmax 输出永远严格大于 0。这确保了模型在训练初期可以探索所有可能,不会武断地把某个选项的概率直接判为 0,有助于训练稳定。
总结:Softmax 在不同地方的统一角色
| 应用场景 | 原始分数 (Logits) 的含义 | Softmax 输出含义 | 最终目的 |
|---|---|---|---|
| 注意力机制 | 词与词之间的原始相关度 | 加权平均用的 注意力权重 | 融合信息,生成上下文感知的向量 |
| 语言模型头 | 模型对下一个词的原始偏好 | 下一个词是某个词的 预测概率 | 计算损失,学习语言规律 |
| MoE 路由器 | 路由器对各个专家的原始偏好 | token 分给各个专家的 门控概率 | 选择专家,并计算负载均衡损失 |
Batch 相关
1. Batch(批次,全量)
定义 :指 整个训练数据集 。
在经典梯度下降(Batch Gradient Descent)中,每次参数更新都会计算所有样本的梯度。
- 特点:梯度估计最准确,但计算成本极高,显存放不下,现在几乎不用。
2. Mini-batch(小批量)
定义 :从全量数据中随机抽取的 一小部分样本 ,用于一次参数更新。
这就是我们常说的 “batch size” 真正所指的对象,例如 32、64、128。
- 随机梯度下降(SGD)及其变体(Adam 等)默认都使用 mini-batch。
- 在 MoE 中:前文讨论的
(B, S, D)中的 B 就是 mini-batch size,代表每步训练喂给模型的独立样本数。
3. Micro-batch(微批量)
定义 :将一个 mini-batch 再次切分 得到的更小单元,目的是在显存受限时模拟更大的 mini-batch。
- 核心用途 : 梯度累积 。
比如你想训练一个 mini-batch size = 128 的模型,但 GPU 显存一次只能塞下 32 个样本。
就把 mini-batch 切成 4 个 micro-batch,每个大小为 32,依次前向、反向计算梯度,但不更新参数,等 4 个 micro-batch 的梯度累加后,再一次性更新参数。这样等效于用 128 的 mini-batch 训练。 - 在 MoE 中 :MoE 模型参数量巨大(很多专家),单个设备可能连 mini-batch 都放不下。这时会使用 micro-batch,通过梯度累积在 不减小专家容量统计稳定性 的情况下完成训练,或者结合专家并行、流水线并行来分布参数和计算。
注意:日常交流中,“batch”常常被用作“mini-batch”的简称。比如“batch size = 32”说的就是 mini-batch size。只有在刻意区分或讨论梯度累积时,micro-batch 才会被单独强调。
Decoder-Only 架构
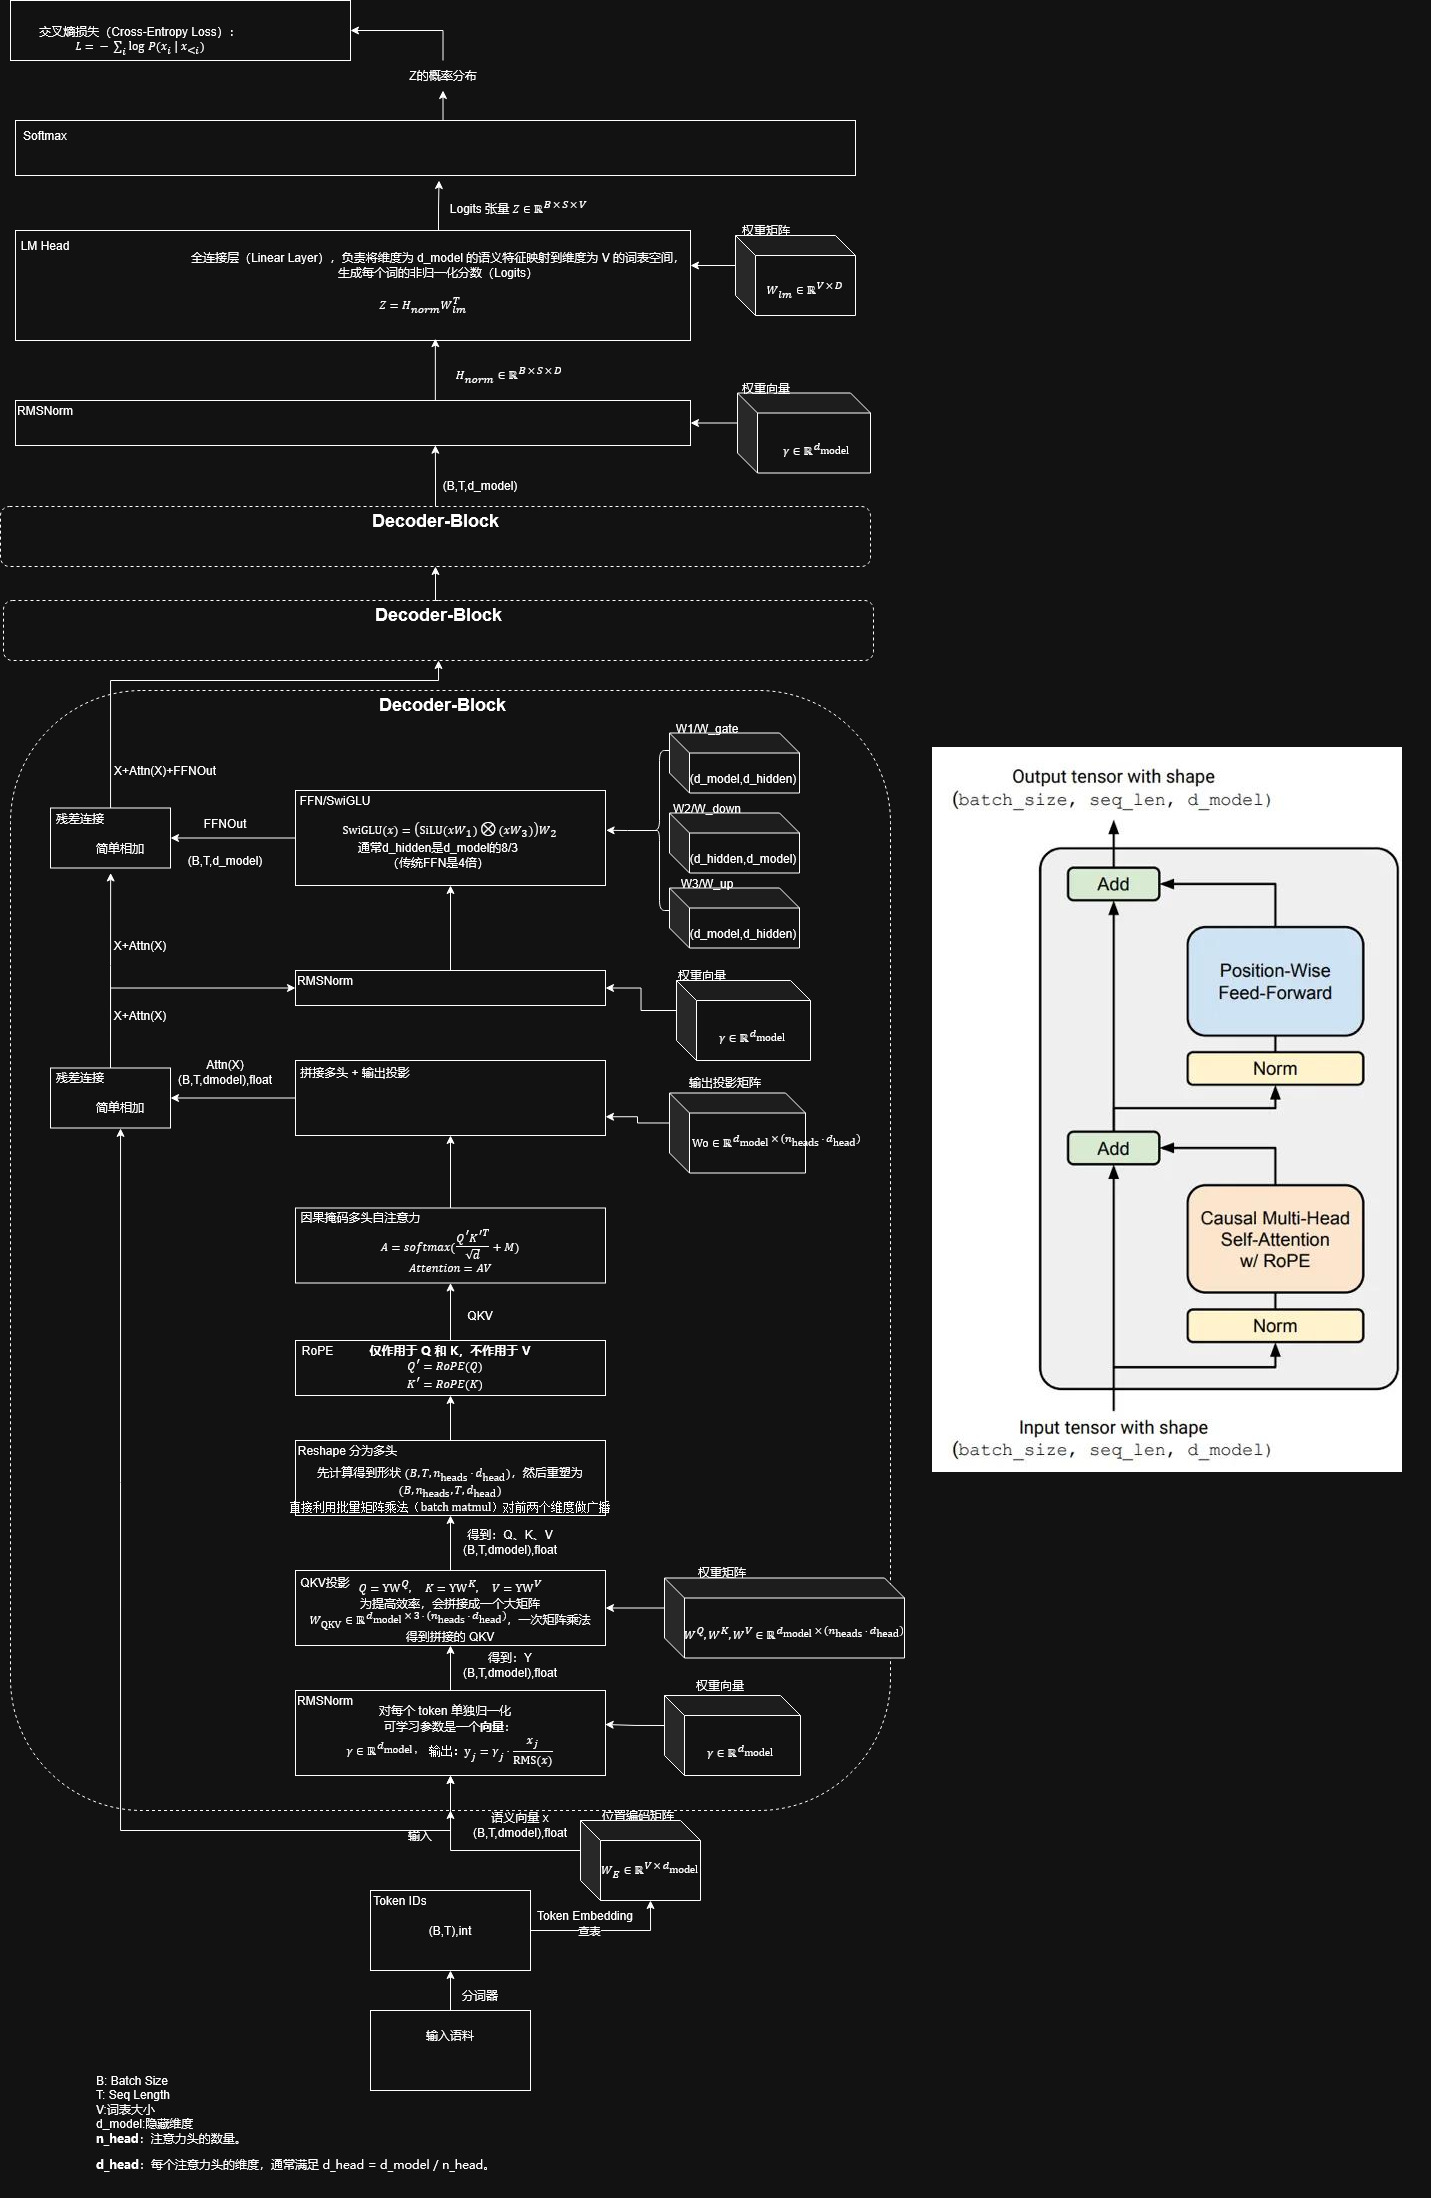
Decoder-Only-MoE
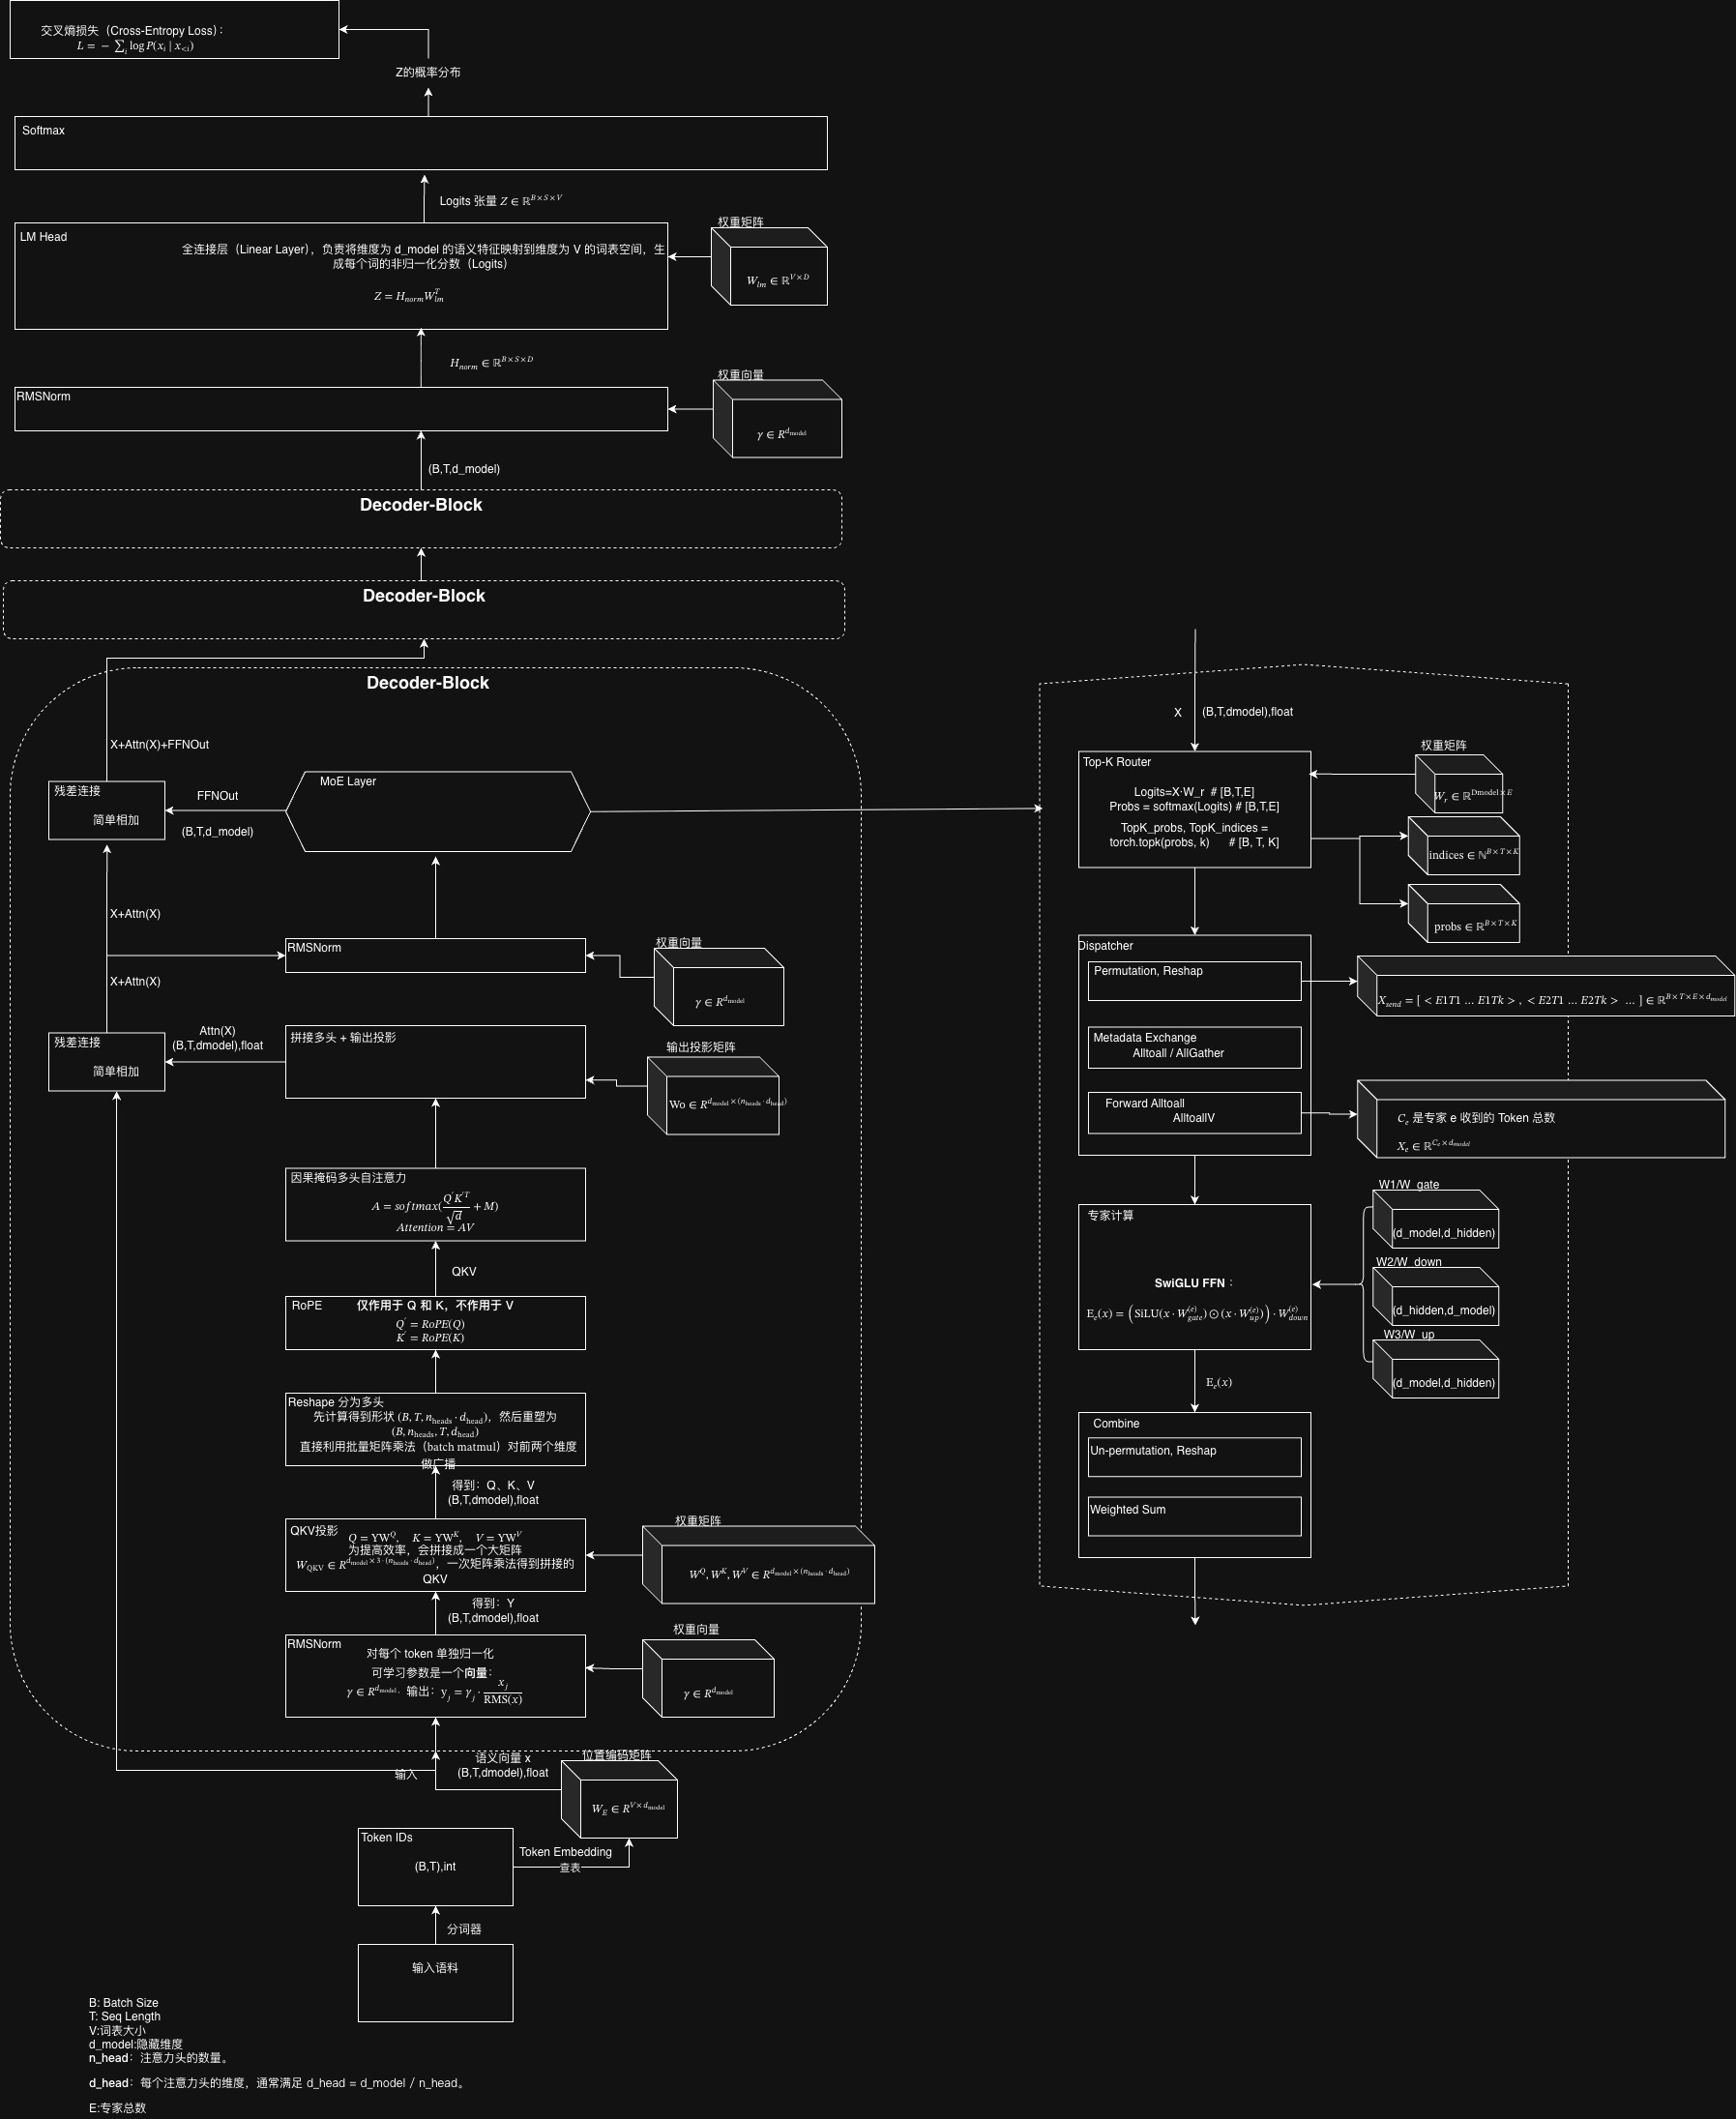
Decoder-Only Backward
标准流程:梯度计算与参数更新是分离的
一次训练迭代的顺序是:
- 前向传播:输入 → 嵌入 → N 个 Transformer 层 → 最终隐藏状态 → LM Head → loss
- 反向传播 (计算梯度):从 loss 开始,沿着计算图反向,依次求出 所有可学习参数的梯度 ,并存储在参数的
.grad属性中, 此时尚未更新任何参数。 - 参数更新 :在所有梯度都计算完毕后,优化器(如 AdamW)一次性使用这些梯度去更新 所有 参数(包括 LM Head、各 Transformer 层的权重、嵌入层等)。
训练的几个阶段
阶段一:预训练(Pre-training, PT)
耗费算力最大(通常占 90% 以上)的阶段。
- 目的: 让模型掌握语言学规律(语法、句法)和海量的通用世界知识,建立底座能力。
- 输入: 数以万亿计的 无标签海量文本(Unlabeled Text),包括网页、书籍、百科、代码、论文等(数据量通常在几个 到十几个 TB)。
- 输出: 基座模型(Base Model)。此时模型只具备“续写”能力,不具备“对话”或“听从指令”的能力。
- 训练原理: 采用 自监督学习(Self-Supervised Learning)。通常使用自回归语言模型(Autoregressive Language Modeling),核心目标是 预测下一个 Token。模型的损失函数(Loss Function)通常采用交叉熵损失(Cross-Entropy Loss):模型根据已经看到的上文 ,去预测下一个最可能出现的词 ,通过比对真实文本进行梯度反向传播,更新数亿至数千亿的参数。
- 训练步骤:
- 数据清洗与脱敏: 去除低质网页、垃圾邮件、重复文本,过滤敏感和有害信息。
- 分词(Tokenization): 利用 BPE(Byte Pair Encoding)等算法将文本切分为 Token 序列。
- 分布式架构初始化: 配置 Transformer 架构(目前主流是 Decoder-only 结构),搭建多机多卡的并行训练环境(数据并行、张量并行、流水线并行等)。
- 千卡集群迭代: 持续喂入数据,进行高密度的矩阵乘法计算,动态调整学习率(通常采用 AdamW 优化器 + Cosine 衰减),直到模型 Loss 降到预期范围。
- 从海量文本中采样,组成批次(Batch Size × 序列长度)。
- 送入 Transformer 模型,得到每个位置对下一个词的预测。
- 计算预测和实际下一个词之间的损失(通常用交叉熵损失)。
- 反向传播,更新模型参数。
补充阶段:增量预训练(Continual Pre-training, CPT)
当现有的基座模型缺乏某些垂直领域知识(如医疗、法律、特定金融业务)或某些小语种能力时,直接重头预训练成本太高,就会引入这个增量阶段。
- 目的: 注入特定领域、行业或特定语言的知识,强化基座模型在专业领域的底座能力。
- 输入: 领域高质文本(如海量法律条文、医学教材)或目标语种的高质语料。
- 输出: 领域 / 多语种 增强基座模型。
- 训练原理: 与预训练完全一致(依然是 Next-token 预测),但在冷启动阶段会特别注意调整学习率(防止直接冲垮原模型的通用通用能力,即“灾难性遗忘”)。
- 训练步骤: 收集领域特定语料 -> 清洗去重 -> 以较低的学习率在基座模型上继续进行自回归训练。
阶段二:监督微调(Supervised Fine-Tuning, SFT)
基座模型虽然知识渊博,但由于天天只学“续写”,你问它“请问什么是万有引力?”,它可能会给你续写出一张物理期末考试卷子。SFT 的目的就是教会它“听懂人话,按格式回答”。
- 目的: 改变模型的交互范式,使其从“文本续写者”变成“能够遵循人类指令并进行对话的助手”。
- 输入: 高质量的 人类标注指令对(Prompt-Response Pairs)。例如:Prompt (输入): 帮我写一首关于秋天的四言律诗。Response (期望输出): 金风送爽,玉露生凉。千山叶落,万里雁行……
- 输出: 指令 / 对话模型(Instruct / Chat Model)。
- 训练原理: 有监督学习。虽然同样是预测下一个 Token,但 在计算 Loss 时会进行掩码(Mask)处理。模型只针对 Response 部分的 Token 预测计算 Loss 并更新参数,Prompt 部分的输入只作为上下文,不参与 Loss 计算(仅对回答部分反向传播)。
- 训练步骤:
- 构建高质量 SFT 数据集: 挑选或合成覆盖各种任务(翻译、代码、续写、问答、推理)的成对数据,数据量通常在 1 万 到 10 万 条左右(质量远比数量重要)。
- 套用标准 Template: 将数据包装成特殊的格式标识符(例如
<|user|>和<|assistant|>),让模型明确边界。 - 微调训练:
- 全参数微调: 调整模型所有参数(通常需要大量显存)。
- 高效参数微调(PEFT): 常用 LoRA、QLoRA 等技术,冻结主模型,仅训练外挂的低秩矩阵,大幅降低显存消耗。
- 详细:
- 准备指令数据集(提示‑回答对)。
- 用基座模型初始化。
- 用非常小的学习率(通常比预训练小 10 倍以上)在指令数据上进行训练,只更新很少的步数(例如几个 epoch)。
- 仍然使用下一个词预测的交叉熵损失,但仅对回答部分反向传播。
阶段三:人类对齐与强化学习(Alignment & RL)
通过 SFT 之后的模型虽然听话了,但它就像一个“满嘴跑火车”的聪明实习生,为了讨好你可能会编造事实(幻觉),或者会顺从地提供造炸弹的方法。这个阶段是为了给它套上“价值观”的缰绳。
目前业界实现对齐主要有两种范式:经典的 RLHF(基于人类反馈的强化学习),以及近两年大热的、更高效的 DPO(直接偏好优化)。
方案 A:经典的 RLHF(基于 PPO 算法)
- 目的: 让模型符合人类的 3H 标准(Helpful 有用, Honest 诚实, Harmless 无害)。
- 输入: 提示词 + 人类偏好对(Prompt + Chosen/Rejected Pair)。
- 输出: 最终的 对齐大模型(Final Alignment Model)。
- 训练原理与步骤: 经典的 RLHF 是一个三阶段循环:
- 训练奖励模型(Reward Model, RM): 给模型同一个问题,让它生成几个不同的回答。让人类(或更强的 AI)给这些回答排序(哪个好,哪个差)。输入这些偏好对,训练一个“裁判模型”(Reward Model),这个裁判输入一个回答,能输出一个分值。
- 环境交互与反馈: 锁死一个参考模型(Reference Model,防止新模型训歪),让策略模型(Actor Model,即待优化的 SFT 模型)针对大量 Prompt 生成回答。
- PPO 策略更新: 裁判模型给回答打分(Reward),同时计算新旧模型的 KL 散度(避免新模型为了拿高分而走向极端或语无伦次)。利用 PPO 算法(近端策略优化) 调节 Actor 模型的参数,使其生成的回答越来越符合裁判的偏好。
方案 B:直接偏好优化(Direct Preference Optimization, DPO)
- 目的: 与 RLHF 相同,但极大地简化了工程实现的复杂度。
- 输入: 同样的提示词 + 偏好对(Prompt, , 好的回答 , 差的回答 )。
- 输出: 对齐后的模型。
- 训练原理: DPO 在数学上证明了可以通过数学变换,直接将奖励函数转化为策略函数本身 。因此,它不需要单独训练一个裁判模型(Reward Model),也不需要经历复杂的 PPO 强化学习动态调参,而是把对齐问题直接变成了一个 二分类的交叉熵损失训练。通过拉大模型生成 与生成 的概率差值来实现对齐。
激活值
假设此时反向传播引擎从上一层(更靠近输出的层)传来了误差信号:对输出 的梯度 。
1. 对权重的梯度(Gradient w.r.t Weights, )
- 物理意义:它衡量的是“如果我稍微改变一下这个层的参数(权重),最终的 Loss 会发生多大的变化”。
- 计算公式:根据 ,有 。
- 注意关键点 :它的计算 必须依赖前向传播时暂存的输入激活值 (这也是为什么前向要 Save for Backward,如果显存不够被丢弃了,就必须用 Activation Checkpointing 重新算出来)。
- 核心作用:指引优化器(Optimizer,如 AdamW)更新模型参数。公式为 。
- 生命周期与系统行为(AI Infra 视角):
- 计算出来后,通常会累加存放在对应参数的
.grad属性中(在 PyTorch 中)。 - 在分布式训练(DP/FSDP)中:它是通信的核心对象。计算出 后,各个 GPU 之间会立即对其发起 AllReduce(或 Reduce-Scatter)操作,以聚合全局的权重梯度。
- 它的生命周期较长,直到 Optimizer Step 执行完毕,并显式调用
zero_grad()后才会被释放。
- 计算出来后,通常会累加存放在对应参数的
2. 对激活值的梯度(Gradient w.r.t Activations, )
- 物理意义:它衡量的是“如果我稍微改变一下这个层收到的输入特征图(激活值),最终的 Loss 会发生多大的变化”。
- 计算公式:根据 ,有 。
- 注意关键点 :它的计算 依赖该层当前的权重矩阵 $W$,而不需要前向传播时的 $X$。
- 核心作用:充当链式法则的“信使”。本层计算出 后,它将作为误差信号,继续传递给它的上一层(即更靠近输入的层),作为那一层的“输入梯度”。
- 生命周期与系统行为(AI Infra 视角):
- 用完即焚 :在 PyTorch 的底层机制中,非叶子节点(Non-leaf nodes,即中间层的激活值)的梯度一旦传递给更浅的一层,完成使命后, 会立即被系统释放(Free)以回收显存(除非你显式调用了
retain_grad()或者挂了 Hook)。 - 激活值梯度通常 不参与跨节点通信(在张量并行 TP 或流水线并行 PP 中除外,PP 的阶段边界需要通过 P2P 通信发送 / 接收激活值梯度)。
- 用完即焚 :在 PyTorch 的底层机制中,非叶子节点(Non-leaf nodes,即中间层的激活值)的梯度一旦传递给更浅的一层,完成使命后, 会立即被系统释放(Free)以回收显存(除非你显式调用了
3. 计算顺序
现在我们聚焦到某一个具体的网络层(比如一个被分配在单张 GPU 上的 Linear 算子)。它接收到了上一层传来的误差信号 。
根据我们上一轮提到的公式:
- 激活值梯度:
- 权重梯度:
这两个计算 都只依赖 ,它们之间是相互独立的矩阵乘法(GEMM)。理论上,谁先算都可以,甚至可以同时算。
但在实际的框架底层(如 PyTorch 的 ATen 库)以及大模型分布式训练(如 Megatron-LM)中,调度器通常会面临算力与通信的博弈:
偏好 A:优先计算“激活值梯度”(保流水线关键路径)
在大多数默认串行调度的场景下,系统倾向于 优先计算激活值梯度 。
- 原因:激活值梯度是反向传播的“关键路径”(Critical Path)。计算出它之后,就可以立刻把信号抛给上一层,让上一层的 GPU 单元尽早开工。
- 特别是对于 流水线并行(Pipeline Parallelism),尽早算出激活值梯度并跨节点发送出去,能有效减少其他 Stage 机器的“气泡”(Bubble)等待时间。权重梯度的计算可以稍微延后,因为它是本地更新参数用的,不阻塞前面的网络层。
偏好 B:优先计算“权重梯度”(保通信 Overlap)
在数据并行(DDP)或 ZeRO 并行场景下,部分优化策略会尝试 优先计算权重梯度 。
- 原因:一旦算出 ,系统就可以立刻触发底层通信库(如 NCCL)发起全局的 AllReduce 或 Reduce-Scatter。
- 尽早触发通信,系统就可以在等待网络传输(RDMA 互联)的同时,回头去计算激活值梯度 。这就是经典的 计算与通信重叠(Compute-Communication Overlap)。