Megatron 分布式训练全维度并行技术文档
数值假设(贯穿全文计算示例):
符号 含义 值 每 GPU batch size 2 序列长度 8192 hidden_size 8192 Transformer 层数 80 注意力头数 64 每头维度 128 专家数 64 top-k 2 dtype 数据精度 bf16 (2 bytes) 架构 Llama-style Pre-RMSNorm + SwiGLU + RoPE 现代 Transformer TP Tensor Parallel 4 SP Sequence Parallel 4 (与 TP 共用通信组) PP Pipeline Parallel 4 CP Context Parallel 2 EP Expert Parallel 8 DP Data Parallel 4 总 GPU 数
目录
1. Tensor Parallelism + Sequence Parallelism (TP+SP)
1.1 总体原理
Tensor Parallelism (TP) 将单个 Transformer 层内的权重矩阵按列或按行切分到多张卡上,每张卡只需持有部分权重并计算部分结果,最后通过通信合并输出。
Sequence Parallelism (SP) 是 TP 的扩展:对 非 TP 参与计算的区域(RMSNorm、残差连接的激活值)按序列维度切分,减少每张卡上的激活值显存占用。SP 与 TP 共用同一个通信组——在 TP 通信组内,激活值按序列切分;在进入 TP 计算区域前通过 All-Gather 恢复完整序列。
1.2 数学推导
1.2.1 标准 TP 数学模型
考虑一个线性层 ,其中 ,。
列切分 (Column Parallelism):
将 按列切分为 份:,其中 。
每张卡 只需计算 ,得到 。输出在特征维度上被切分。
特征维度:每个 token 用一个长度为
hidden_size的向量表示,向量的每个元素可以理解为一个“特征”。
行切分 (Row Parallelism):
将 按行切分为 份:,其中 。
对应地,输入 也按特征维度切分:,其中 。
每张卡 计算 ,得到完整特征维度但只有部分贡献的 ,需要 All-Reduce 求和得到最终 。
1.2.2 SP 的激活值切分推导
在标准 TP 中,每张卡在非 TP 区域(RMSNorm)仍持有完整的 激活值。
SP 切分的是 序列维度 seq_len,而不是特征维度 hidden_size。
而 RMSNorm 是对 每个 token 自己的特征向量 做归一化,不同 token 之间没有依赖。因此可以安全地按 切分。
因此,在非 TP 区域,激活值只需 ,而非 。
SP 的通信优化:
标准 TP 流程:
[SP 激活: B*S/N*H] -> All-Gather -> [B*S*H] -> QKV 列切分 -> Attention -> All-Reduce -> [B*S*H] -> RMSNormSP 优化后流程(All-Gather + Reduce-Scatter 融合):
[SP 激活: B*S/N*H] -> All-Gather(S) -> [B*S*H] -> QKV 列切分 -> Attention -> Reduce-Scatter(S) -> [B*S/N*H] -> RMSNorm这样,TP 的 All-Reduce 被分解为 All-Gather + Reduce-Scatter,正好与 SP 的区域切换对齐,不引入额外通信。
数学等价性证明:
- All-Reduce = All-Gather + Reduce-Scatter(Ring All-Reduce 的分解)
- 标准 TP 的 All-Reduce 对 求和得 ,然后每卡持有完整的
- SP 的 Reduce-Scatter 对 求和并按 切分,每卡得到
- 计算结果等价,只是存储方式不同(SP 下每卡只存 片段)
1.3 切分内容精确描述
1.3.1 参数切分
| 层 / 组件 | 权重 | 切分方式 | 每卡形状 | 切分维度 |
|---|---|---|---|---|
| QKV 投影 | 列切分 | 输出维度按列 | ||
| Output 投影 | 行切分 | 输入维度按行 | ||
| MLP | 列切分 | 输出维度按列 | ||
| MLP | 列切分 | 输出维度按列 | ||
| MLP | 行切分 | 输入维度按行 | ||
| Embedding | 按词表行切分 | 词表维度 V |
切分原理详解:
- QKV 列切分 : 的输出维度 对应 个 head 的 QKV。每个矩阵按列切分 份,每卡得到 ,即 16 个 head。每卡只需计算自己负责的 16 个 head 的 attention。
- Output 行切分: 的输入维度 对应所有 head 的拼接结果。每卡只有 16 个 head 的 attn 输出,因此 按行切分,每卡 ,计算 得到部分和,All-Reduce 求和。
- MLP 列切分 : 输出维度 按列切 份,每卡 ,。每卡计算部分门控状态。
- MLP 列切分 : 输出维度 按列切 份,每卡 ,。每卡计算部分上投影状态。
- MLP 行切分 : 输入维度 按行切 份,每卡 ,。每卡将 SiLU 门控后的中间状态乘以对应行块得到部分和,All-Reduce 求和。
SwiGLU 结构说明:现代大模型使用 SwiGLU 替代传统 FFN:
其中 (也叫 Swish 激活函数), 为 sigmoid 函数。三个权重分别为 , , 。TP 切分时 和 按列切分, 按行切分。
为了保持参数量一致,Llama 实际上把 SwiGLU 的中间维度从 调小为 (再向上取整到 256 的倍数)
1.3.2 梯度切分
梯度的切分方式与参数完全一致——因为梯度形状与参数相同。列切分参数的梯度也是列切分,行切分参数的梯度也是行切分。TP 组内每张卡只计算和持有自己那部分参数的梯度。
1.3.3 优化器状态切分
TP 本身不切分优化器状态。优化器状态由 DP(或 ZeRO)负责切分。TP 组内的每张卡独立维护自己持有的参数所对应的优化器状态(如 Adam 的 m 和 v)。
1.3.4 激活值切分(精确到层内位置)
激活值切分总结表:
| 激活值位置 | 切分方式 | 每卡形状 | 区域 |
|---|---|---|---|
| RMSNorm1 输入 / 输出 | SP: 序列切分 | SP 区域 | |
| All-Gather 后, QKV 投影前 | 完整序列 | TP 区域 | |
| QKV 投影后 | TP: 特征切分 | TP 区域 | |
| Attention 中间(Q,K,V,attn) | TP: head 切分 | TP 区域 | |
| Output 投影后(RS 前) | TP: 完整特征, 部分和 | TP 区域 | |
| Reduce-Scatter 后(残差前) | SP: 序列切分 | SP 区域 | |
| RMSNorm2 输入 / 输出 | SP: 序列切分 | SP 区域 | |
| MLP /后 | TP: 特征切分 | TP 区域 | |
| MLP 后(RS 前) | TP: 完整特征, 部分和 | TP 区域 | |
| 层间传递的激活值 | SP: 序列切分 | SP 区域 |
1.4 通信组构成
- TP 通信组: 同一节点内的 张卡
- SP 与 TP 共用同一通信组: SP 不是独立的并行维度,而是 TP 区域内激活值的存储策略
- 物理拓扑建议: 同一 NVLink 域内(TP 通信频繁,需要高带宽)
1.5 通信方式
| 通信点 | 通信方式 | 数据流 |
|---|---|---|
| SP->TP 过渡(Attention 前) | All-Gather (沿 S 维度) | 4 卡各持 -> 每卡得 |
| TP 区域结束(Attention 后) | Reduce-Scatter (沿 S 维度) | 4 卡各持 (部分和) -> 每卡得 |
| SP->TP 过渡(MLP 前) | All-Gather (沿 S 维度) | 同上 |
| TP 区域结束(MLP 后) | Reduce-Scatter (沿 S 维度) | 同上 |
标准 TP(无 SP)使用 All-Reduce 替代上述 All-Gather + Reduce-Scatter 对。SP 将 All-Reduce 分解为 All-Gather + Reduce-Scatter,并与 SP 区域的序列切分自然对齐。
1.6 通信数据量计算
1.6.1 单次通信量公式
All-Gather (SP->TP):
- 每卡发送:
- 每卡接收:
- 每卡总通信量(发送 + 接收):
Reduce-Scatter (TP->SP): 与 All-Gather 通信量相同(对称操作)
1.6.2 具体数值计算
代入 :
每卡发送量:
每卡接收量:
每卡总通信量:
或等价:
1.6.3 单层总通信量
每层: 2 次 All-Gather + 2 次 Reduce-Scatter = 4 次通信
单层每卡总通信量:
80 层前向 TP 通信总量:
反向通信量与前向相同: 80 GiB
前向 + 反向 TP 通信总量: 160 GiB/ 卡
1.7 优化手段
1.7.1 All-Gather + Reduce-Scatter 替代 All-Reduce
标准 TP 使用 2 次 All-Reduce(每层),SP 方案用 All-Gather + Reduce-Scatter 替代,总通信量相近但激活值显存降低 4 倍。
1.7.2 通信 - 计算重叠
- 在 Attention 计算 QKV 投影的同时,可以启动下一层的 All-Gather
- Megatron 使用 CUDA stream 实现异步通信
1.7.3 SP 与选择性重计算结合
SP 将激活值降低 倍。结合选择性重计算(不存储 attention 矩阵,反向时重计算),可进一步降低显存。
1.8 前向与反向流程详解
前向流程(单层)
| 输入: | SP 切分 |
| (1) RMSNorm1(x) → | SP |
| (2) All-Gather(S) → | |
| (3) → reshape → |
TP 列切分 |
| (4) → |
TP |
| (5) → (部分和) | TP 行切分 |
| (6) Reduce-Scatter(S) → | |
| (7) → | SP |
| (8) RMSNorm2(x) → | SP |
| (9) All-Gather(S) → | |
| (10a) → | TP 列切分 |
| (10b) → | TP 列切分 |
| (10c) → | TP, 逐元素 |
| (11)→ (部分和) | TP 行切分 |
| (12) Reduce-Scatter(S) → |
反向流程(单层)
对应关系: 正向 All-Gather 的反向 =Reduce-Scatter, 正向 Reduce-Scatter 的反向 =All-Gather
| 梯度输入: | SP 切分 |
| (12) All-Gather(S) → | |
| (11)下投影 的梯度与 → |
TP |
| (10) 计算 |
TP |
| (9) Reduce-Scatter(S) → dL/dx in B*S/TP*H |
  +--(9) Reduce-Scatter(S) -> dL/dx in B*S/TP*H     [ 通信: 64MiB send, 192MiB recv]
  +--(8) RMSNorm2 反向: 逐位置计算, 无通信
  +--(7) 残差反向: dL/dattn_out = dL/dx; 残差直通
  +--(6) All-Gather(S) -> dL/dY_full in B*S*H      [ 通信: 64MiB send, 192MiB recv]
  +--(5) dL/dattn_i = dL/dY_i @ W_o_i^T; dL/dW_o_i   [TP, 无通信]
  +--(4) Attention 反向: dL/dQ_i, dL/dK_i, dL/dV_i   [TP, 无通信]
  +--(3) QKV 反向: dL/dx_full_i; dL/dW_qkv_i          [TP, 无通信]
  +--(2) Reduce-Scatter(S) -> dL/dx in B*S/TP*H     [ 通信: 64MiB send, 192MiB recv]
  +--(1) RMSNorm1 反向: 逐位置计算, 无通信
  +-- 输出梯度传给上一层
反向通信量 = 正向通信量 = 4 次 x 256 MiB = 1024 MiB/ 层
2. Pipeline Parallelism (PP)
2.1 原理
Pipeline Parallelism 将 Transformer block 按层 (80 层) 切分到 个流水线阶段(stage),每个 stage 负责连续的 20 层。数据像流水线上的产品一样,逐 stage 传递。
核心问题 – 气泡 (Bubble): 如果严格串行(等待所有前向完成后再反向),则 GPU 利用率极低。Megatron 采用 1F1B (One Forward, One Backward) 调度策略来减少气泡。
1F1B 调度原理:
- warmup 阶段:stage i(i 从 0 开始)先执行 次前向
- 稳态阶段:交替执行 1 次前向 + 1 次反向
- cooldown 阶段:执行剩余的反向
气泡数量: 次前向的时间
1F1B 调度时序图 (以 , micro-batches 为例):
其中 F= 前向, B= 反向, 数字是 micro-batch 编号。
2.2 激活值
在 Transformer 架构中,PP 沿着层(Layer)维度进行切分。假设 Stage i 负责 Layer 0~19,Stage i+1 负责 Layer 20~29。
- 前向传播 (Forward):Stage i 将 Layer 19 的输出
hidden_states发送给 Stage i+1 作为其输入。 - 反向传播 (Backward):Stage i+1 计算完 Layer 20 的梯度后,将关于该
hidden_states的梯度grad_hidden_states发送回 Stage i。
在最基础的设定下,这个边界激活值的形状(Shape)为: , 单次 P2P 传输的数据量为: Bytes。
2.2.1 结合 TP、SP、CP 时的激活值形态
当 PP 与 Tensor Parallelism (TP)、Sequence Parallelism (SP) 和 Context Parallelism (CP) 组合时,由于输入序列在不同维度上被分片(Sharding),跨 PP 边界的激活值 Shape 和通信拓扑会发生显著变化。
1. PP + TP (无 Sequence Parallelism)
在传统的 Megatron-LM 纯 TP 模式下,每个 Transformer 层的输入和输出在 TP 组内是完全复制(Replicated)的。
- 边界形态:每个 TP Rank 都在 PP 边界处持有完整的 $[S, B, H]$ 激活值。
- 通信模式:Stage i 的 TP Rank k 直接将大小为 的数据通过
send/recv发送给 Stage i+1 的 TP Rank k。
2. PP + TP + SP (Sequence Parallelism)
SP 将 AllReduce 拆解为 Reduce-Scatter 和 All-Gather,使得各层之间的激活值在序列维度 上被切分。
- 边界形态:在 PP 边界处,激活值被 TP 组切分成了 份。每个 Rank 持有的 Shape 为:
- 通信模式:Stage i 的 TP Rank k 只需发送 给 Stage i+1 的 TP Rank k。
3. PP + TP + SP + CP (Context Parallelism)
CP 进一步在序列维度上对数据进行切分(例如 DeepSpeed Ulysses 或 Megatron CP 方案)。
- 边界形态:序列维度被 SP 和 CP 共同切分。每个 Rank 在 PP 边界处的激活值 Shape 变为:
- 通信模式:Stage i 中的 (CP Rank j, TP Rank k) 将这一小块激活值发给 Stage i+1 中对应的 (CP Rank j, TP Rank k)。
2.2.2 不同 PP 调度策略对激活值显存的影响
PP 的调度策略决定了在同一时刻,GPU 显存中必须驻留多少个 Micro-batch 的激活值。这是 AI Infra 系统设计中权衡“显存占用”与“Pipeline Bubble(气泡)”的核心考量。
假设 Micro-batch 总数为 。
1. GPipe (Default Batching)
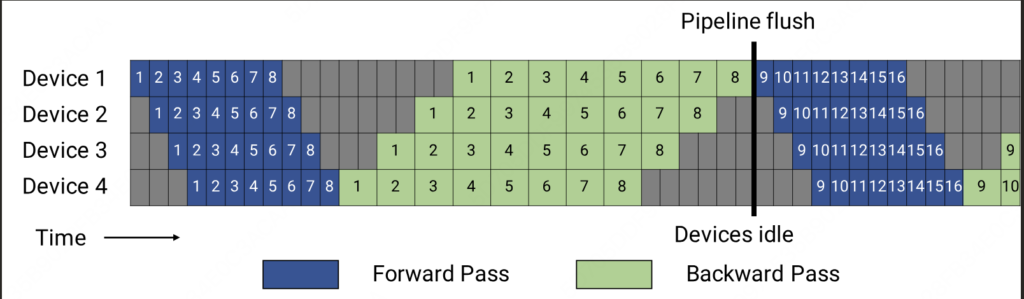
- 调度逻辑:前向传播所有的 个 Micro-batch,然后再反向传播 个 Micro-batch。
- 激活值驻留量:Stage 1 必须将所有 个 Micro-batch 的前向激活值全部保存在显存,直到对应的反向传播到来。
- 显存占用峰值:。通常 ,这会导致极大的显存压力,目前主流 LLM 训练已基本弃用。
2. 1F1B (One Forward One Backward)
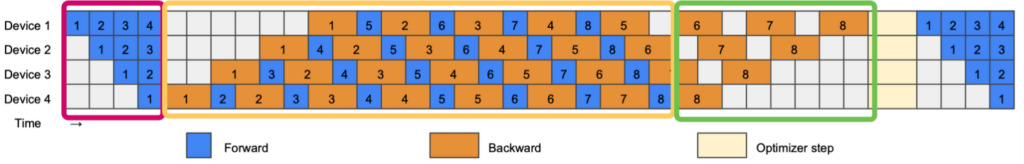
也有这种:
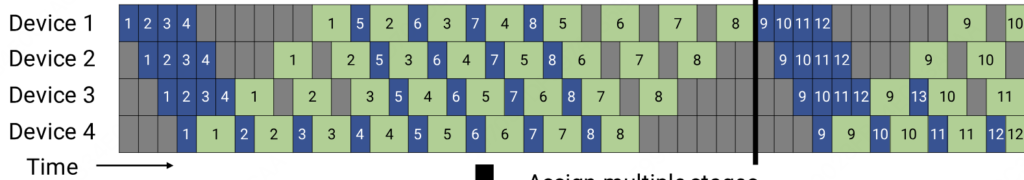
- 调度逻辑:进入稳态后,交替执行 1 个 Forward 和 1 个 Backward。
- 激活值驻留量:每个 Stage 需要驻留的 Micro-batch 激活值数量取决于它在 Pipeline 中的位置。Stage i(从 0 开始)在稳态前需要执行 个 Warmup Forward。
- 显存占用峰值:最多只需缓存 个 Micro-batch 的激活值。即 。
3. Interleaved 1F1B (Megatron-LM)
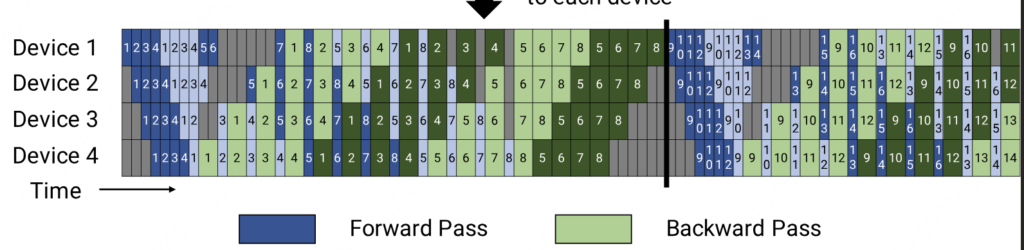
- 调度逻辑:将一个物理 GPU 映射到 个虚拟 Stage(Virtual Stages / Model Chunks)。通过让不同阶段的计算交错,缩小最终的 Pipeline Bubble。
- 激活值驻留量 :由于模型被切得更碎(每块层数变为 ),但需要处理的 Chunk 数量增加了 倍。驻留的 Micro-batch 数量依然由 决定,但由于每个 Chunk 变小,整体激活值 峰值显存占用与基础 1F1B 相当。
- 网络特征 (关键):Interleaved 1F1B 的跨 Stage 边界数量增加了 倍,导致 P2P 通信频率和通信总量增加了 倍。
4. Zero-Bubble (如 ZB-H1 / V-Schedule)
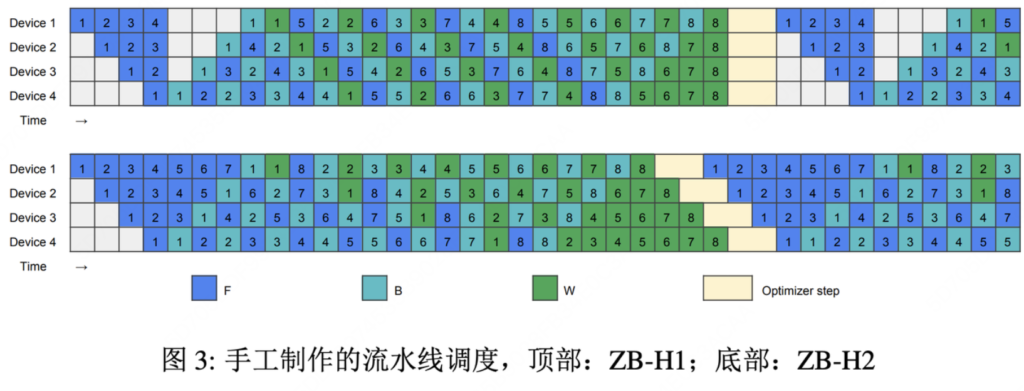
- 调度逻辑:将 Backward 进一步拆解为计算激活值梯度的 和计算权重梯度的 , 利用 来填补传统 1F1B 留下的气泡。
- 激活值驻留量 :为了填补气泡, 被大幅延后执行。因为权重梯度的计算需要依赖 前向激活值,延后 意味着前向激活值的生命周期被拉长。
- 显存占用峰值 : 显著高于 1F1B。为了换取接近零的气泡,系统必须在显存中缓存多于 个 Micro-batch 的激活值(具体取决于 的排布位置)。
2.3 数学推导
2.3.1 显存分析
假设 层均匀切分到 个 stage,每 stage 层。
1F1B 下,stage i 的最大激活值份数:
- Stage 0: 缓存最多 份 micro-batch 的激活值
- Stage 1: 3 份
- Stage 2: 2 份
- Stage 3: 1 份
2.3.2 气泡占比
设单次前向时间为 ,单次反向时间为 ,micro-batch 数为 。
气泡占比:
当 :
当 时,气泡占比趋近于 0。
2.3.3 通信量
PP 的通信发生在相邻 stage 之间,是 P2P 通信。
前向: stage i -> stage i+1 传递激活值
注意:如果同时使用了 SP,则层间传递的激活值是 ,因为 SP 区域下层间传递的是序列切分后的激活值。
实际前向 P2P 通信量(含 SP):
反向: stage i+1 -> stage i 传递梯度,通信量相同:
2.4 切分内容精确描述
| 切分对象 | 切分方式 | 说明 |
|---|---|---|
| 参数(权重) | 按层切分 | 每 stage 持有连续的 层的全部权重 |
| 梯度 | 按层切分 | 与参数一致,每 stage 只持有所在层的梯度 |
| 优化器状态 | 按层切分 | 与参数一致 |
| 激活值(层间) | 按层切分 | 每 stage 只持有自己 20 层的中间激活值 |
| 激活值(micro-batch 缓存) | 1F1B 调度缓存 | stage i 最多缓存 份 micro-batch 的激活值 |
精确说明:
- PP 切分的是 层间 的划分,不是层内的切分
- 每 stage 的权重是完整的(在该 stage 内的 20 层中,权重不被 TP 以外的并行度切分)
- 激活值方面,PP 切的是哪些层的激活值在哪张卡上——stage 0 的卡只存储 layer 1-20 的激活值
- 层内激活值 不被 PP 切分(被 TP/SP 切分)
2.5 通信组构成
- PP 通信组: 相邻 stage 之间两两通信
- 通信是 P2P Send-Recv
- stage i 只与 stage i-1 和 stage i+1 通信
- stage 0 只与 stage 1 通信(前向发送)
- stage 只与 stage 通信(反向接收梯度)
2.6 通信方式
| 通信点 | 通信方式 | 方向 | 数据 |
|---|---|---|---|
| 前向: stage i -> i+1 | P2P Send-Recv | 前向 | 激活值 |
| 反向: stage i+1 -> i | P2P Send-Recv | 反向 | 梯度 |
2.7 优化手段
2.7.1 1F1B 调度
显存从 份降低到 份。
2.7.2 Interleaved 1F1B (交错式调度)
Megatron-LM v2 的优化:将每 stage 的连续层再切分为多个 chunk(如 2 个 chunk),交错执行不同 chunk 的前向 / 反向。气泡从 降低到 ,其中 是每 stage 的 chunk 数。代价:P2P 通信次数增加 倍,但每次通信量减少。
2.7.3 Pipeline Bubble Fill
在气泡时间内执行其他有用计算(如 DP 的梯度同步),隐藏通信延迟。
2.7.4 micro-batch 数量优化
增大 可以降低气泡比例,但增加显存。需要平衡。
2.8 前向与反向流程
前向流程
[micro-batch m 输入] -> Stage 0 (Layer 1-20)
  | 计算 20 层前向
  | 缓存中间激活值(用于反向)
  | P2P Send: 激活值 -> Stage 1  [64 MiB]
  v
Stage 1 (Layer 21-40)
  | 计算 20 层前向
  | 缓存中间激活值
  | P2P Send: 激活值 -> Stage 2  [64 MiB]
  v
Stage 2 (Layer 41-60)
  | 计算 20 层前向
  | 缓存中间激活值
  | P2P Send: 激活值 -> Stage 3  [64 MiB]
  v
Stage 3 (Layer 61-80)
  | 计算 20 层前向
  | 计算 loss
  | 开始反向
反向流程
Stage 3 (Layer 80->61)
  | 反向计算 20 层梯度
  | 释放对应前向激活值
  | P2P Send: 梯度 -> Stage 2  [64 MiB]
  v
Stage 2 (Layer 60->41)
  | 反向计算 20 层梯度
  | 释放激活值
  | P2P Send: 梯度 -> Stage 1  [64 MiB]
  v
Stage 1 (Layer 40->21)
  | 反向计算 20 层梯度
  | 释放激活值
  | P2P Send: 梯度 -> Stage 0  [64 MiB]
  v
Stage 0 (Layer 20->1)
  | 反向计算 20 层梯度
  | 释放激活值
  | 梯度就绪,等待 DP 同步
每层前向计算流程(Pre-RMSNorm + SwiGLU):
[ 输入 x] (来自上游 stage 或 embedding)
  |
  +-- RMSNorm1(x) -> x_norm           [ 无通信]
  +-- Attention(x_norm) -> attn_out    [TP 通信: AG+RS, 见 Ch1]
  +-- x = x + attn_out                 [ 残差连接, 无 dropout]
  +-- RMSNorm2(x) -> x_norm2          [ 无通信]
  +-- SwiGLU FFN(x_norm2) -> ffn_out  [TP 通信: AG+RS, 见 Ch1]
  +-- x = x + ffn_out                  [ 残差连接, 无 dropout]
  |
[ 输出 x] (传递给下游 stage 或输出层)每层反向流程:
[ 梯度 dL/dx] (来自下游 stage)
  |
  +-- dL/dx_norm2 = dL/dx (残差直通)
  +-- RMSNorm2 反向: dL/dx += dL/dx_norm2   [ 无通信]
  +-- SwiGLU FFN 反向: dL/dffn_out, dL/dW_gate, dL/dW_up, dL/dW_down  [TP 通信]
  +-- dL/dx += dL/dffn_out (残差直通)
  +-- RMSNorm1 反向: dL/dx_norm = dL/dx     [ 无通信]
  +-- Attention 反向: dL/dattn_out, dL/dW_qkv, dL/dW_o  [TP 通信]
  +-- dL/dx += dL/dattn_out (残差直通)
  |
[ 梯度 dL/dx] (传递给上游 stage)
2.9 一些其他 overlap 相关优化
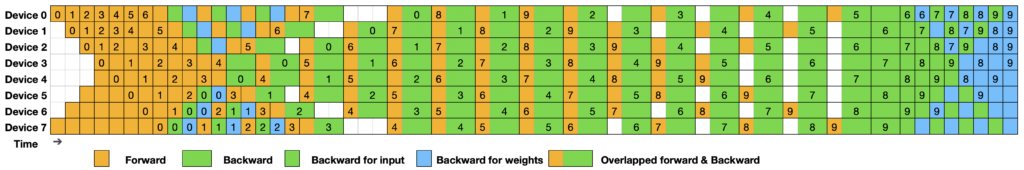
1. deepseek dualpipe https://zhuanlan.zhihu.com/p/28277195890
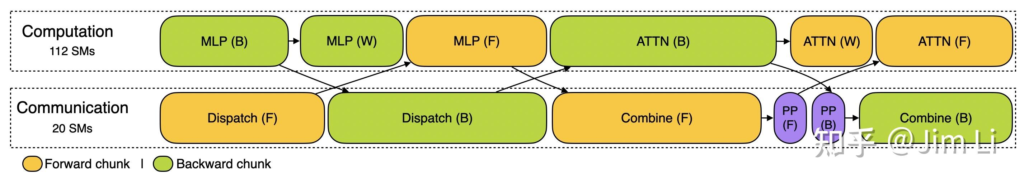
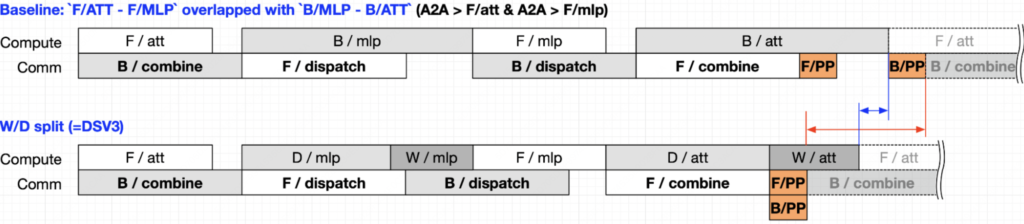
2. 1f1b 实现类似 dualpipe https://developer.nvidia.cn/blog/1f1b-moe-a2a-computing-overlap/
3. 首尾不均衡问题
首 stage(Stage 0):
- 有 Embedding 层——额外的参数和计算(词表 V × H 的 lookup + dropout)
- 接收原始输入数据,需要做 tokenization / positional embedding
- 反向传播结束时,梯度从这里开始传给上游(没有上游 stage 传梯度给它)
尾 stage(Stage 3):
- 有 Output LM Head(Wout∈[H,V])——计算 logits 和 loss
- 计算 Cross-Entropy Loss
- 反向传播从这里开始(第一个做反向的 stage)
- 没有下游 stage 需要它发送激活值
中间 stage(Stage 1, 2):
- 只有 Transformer 层(Attention + MLP/MoE)
- 前向收上游激活值,反向收下游梯度
解决:非均匀层切分(Non-uniform Pipeline Split)
不按层数均分,而是按 计算量 或显存 切分:
如果首 stage 有 Embedding(额外显存)→ 给它少几层 Transformer
如果尾 stage 有 LM Head(额外计算)→ 给它少几层 Transformer

例如:
Stage 0: Embedding + 18 层 (减轻以补偿 Embedding 显存)
Stage 1: 20 层
Stage 2: 20 层
Stage 3: 22 层 + LM Head (增加层数但 LM Head 计算量相对小)
Megatron-LM 支持 num_layers_per_virtual_pipeline_stage 和自定义层分配。
3. Context Parallelism (CP)
Context Parallelism(上下文并行)将输入序列沿序列维度 切分到多张卡上,使每张卡只需处理序列的一个子段,从而突破单卡显存对长序列的限制。CP 主要切分的是 Attention 层的激活值(具体为 及其中间产物),对 MLP 层和 RMSNorm 层的激活值不做跨卡通信(这些层在序列维度上是独立的,各卡只需处理自己那段序列即可)。
CP 有三种主流实现变体,下面分别详述。
3.1 公共基础
序列切分: 将长度为 的序列均匀切分到 张卡上,每卡处理 个 token。
数值假设(本节通用):
- (CP 并行度)
- dtype = bf16(2 bytes)
切分内容精确描述:
- 参数:各项权重矩阵均不切分。Attention 的 和 MLP 的 在所有 CP 卡上完整复制。
- 梯度:不切分(梯度在 CP 组内通过 All-Reduce 同步)。
- 优化器状态:不切分。
- 激活值切分(精确到层内位置):
- Attention 层的输入 :沿序列切分为 。 这是层间激活值在进入 Attention 前被切分。
- :每卡计算自己那段的 ,这些是 层内中间激活值,标准 Attention 需要全序列 才能计算 ,因此需要跨卡通信。
- Attention 矩阵 :每卡需全序列 ,这是 CP 通信的核心来源。
- Attention 输出 :序列维度已切分,后续 投影在各卡独立完成。
- MLP 层 :MLP(SwiGLU)在序列维度上完全独立,各卡只需处理自己的 个 token, 无需跨卡通信。
- RMSNorm:序列维度独立运算,各卡处理自己的子段,无需跨卡通信。
3.2 变体一:Ring-Attention
3.2.1 原理
Ring-Attention 采用 P2P 环形通信,将 在 CP 组的卡间循环传递。每卡在收到其他卡的 后,立即计算本地 与这部分 的 Attention 部分分数,累加到本地 上。
核心思想:计算与通信重叠——当卡 i 在用卡 j 的 计算 Attention 时,同时在接收卡 j+1 的 。
3.2.2 数学推导
标准 Attention:
分块计算(卡 i 持有 ,需要所有 ):
其中 表示在线 softmax 的第 j 块更新(需维护全局最大值和指数和的运行状态)。
在线 softmax 更新公式:
设当前已处理块的最大值为 ,指数和为 ,累加输出为 。处理新块 时:
3.2.3 前向流程
Card 0 (S_0)     Card 1 (S_1)     ...     Card N-1 (S_{N-1})
    |                 |                     |
    v                 v                     v
  Q0,K0,V0          Q1,K1,V1          Q_{N-1},K_{N-1},V_{N-1}

Step 0: 每卡用本地 K,V 计算本地 Attention 部分
         |--- P2P Send K_i,V_i -> Card (i+1)%N --->

Step 1: 每卡收到 Card (i-1) 的 K,V, 计算与本地 Q 的 Attention
        同时 P2P Send 当前 K,V 到下一卡

Step 2 ~ N-1: 重复上述过程, 直到每卡都见过所有 K,V

最终: 每卡的 O_i 包含全序列信息
通信细节:
- 通信组:CP 组内 张卡
- 通信方式:P2P Send-Recv(环形),共 轮
- 每轮通信数据量:发送 和 ,各 bytes
- 单轮通信量: bytes = 256 MiB
- 总通信量(前向): MiB
- :256 MiB
- :768 MiB
3.2.4 反向流程
反向传播需计算 的梯度。由于前向 在卡间循环,反向需相应的梯度回传。
反向传播(Ring-Attention 反向):

Card i 持有 dO_i (来自上一层的梯度) [B, S_local, H]

Step 0: 用本地 Q_i, K_i, V_i 计算本地部分的 dQ_i, dK_i, dV_i
        |--- P2P Send dK_j, dV_j -> 前一卡(逆向环) --->

Step 1 ~ N-1:
  每卡收到来自 "下一卡" 的 dK_j, dV_j
  用本地 Q_i 和缓存的 K_j, V_j 计算:
    dQ_i  += dP_{ij}^T @ K_j  (累加到本地 dQ)
    dK_j  += dP_{ij}^T @ Q_i  (需传回)
    dV_j  += softmax(P_{ij})^T @ dO_i  (需传回)

P2P Send dK_j, dV_j 回前一卡反向通信量:与前向相同, MiB
总通信量(前向 + 反向): MiB
- :512 MiB
3.2.5 优化手段
- 计算 - 通信重叠:Ring-Attention 的核心优势——计算当前块时预取下一块
- Flash-Attention 集成:将分块计算融合为 Flash-Attention kernel,减少 HBM 读写
- KV 缓存复用:前向时缓存收到的 ,避免反向时重新通信(代价是显存增加)
3.3 变体二:AllGather 方案
3.3.1 原理
AllGather 方案更直接:每卡持有 的 ,通过 All-Gather 收集全序列的 ,然后各卡独立计算完整的 Attention。
3.3.2 数学推导
每卡 i 持有 。
All-Gather K, V:
计算完整 Attention:
每卡只需计算自己 行的 Attention,但需全序列的 。
3.3.3 前向流程
Card 0 (S_0)       Card 1 (S_1)      ...    Card N-1 (S_{N-1})
    |                   |                      |
    v                   v                      v
  Q0,K0,V0            Q1,K1,V1             Q_{N-1},K_{N-1},V_{N-1}

Step 1: AllGather(K) -> 每卡获得 K_full [B, S, H]
        AllGather(V) -> 每卡获得 V_full [B, S, H]

        通信量: 每卡发送 B*S_local*H*2 bytes (K), 接收 B*S*H*2 bytes (K)
        同理 V -> 总通信量 = 2 * B * S * H * 2 = 512 MiB

Step 2: 每卡独立计算 O_i = Attn(Q_i, K_full, V_full)
        Attention 矩阵: [B, N_h, S_local, S]

Step 3: 输出 O_i [B, S_local, H], 过 W_o 投影(各卡独立)
通信细节:
- 通信组:CP 组内 张卡
- 通信方式:All-Gather(收集 K 和 V)
- 总通信量(前向 K+V): bytes = 512 MiB
3.3.4 反向流程
反向传播:

Card i 持有 dO_i [B, S_local, H]

Step 1: 用前向缓存的 K_full, V_full 计算:
  dQ_i     = dP_i @ V_full         [B, S_local, H]
  dK_full  = dP_i^T @ Q_i          [B, S, H] (每卡只算了 S_local 行的梯度)
  dV_full  = softmax(P_i)^T @ dO_i [B, S, H]

Step 2: dK_full 和 dV_full 需在 CP 组内 Reduce-Scatter:
  - Reduce-Scatter(dK_full) -> 每卡得到 dK_i [B, S_local, H]
  - Reduce-Scatter(dV_full) -> 每卡得到 dV_i [B, S_local, H]

  通信量: 2 * B * S * H * 2 = 512 MiB
总通信量(前向 + 反向): MiB
比 Ring-Attention(512 MiB)多一倍,但实现更简单,计算效率更高(不需要在线 softmax)。
3.3.5 优化手段
- 只 AllGather K,V,不 AllGather Q:减少通信量
- Flash-Attention:用 Flash-Attention kernel 计算 的 Attention
- QKV 融合 AllGather:一次 All-Gather 同时收集 K 和 V(拼接为 )
- 滑动窗口 Attention:局部注意力只需 AllGather 窗口内的 K,V
3.4 变体三:Ulysses All-to-All
3.4.1 原理
Ulysses 采用与上述两种方案完全不同的策略:通过 All-to-All 通信在「序列切分」和「注意力头切分」之间切换。
- 前向前:每卡持有 的所有头的
- All-to-All 后:每卡持有 (全序列)的 个头的
- 每卡独立计算自己负责的那些头的完整 Attention(序列维度完整,头维度切分)
- 计算完成后:再次 All-to-All 切回序列切分模式
3.4.2 数学推导
初始状态(序列切分):
All-to-All 重排:
这是在序列维度和头维度之间的数据重排。
计算 Attention:
第二次 All-to-All(切回):
3.4.3 前向流程
Card 0               Card 1              ...    Card N-1
  |                    |                          |
  v                    v                          v
Q0,K0,V0             Q1,K1,V1                Q_{N-1},K_{N-1},V_{N-1}
[B, S_local, N_h, d_h]                       [B, S_local, N_h, d_h]

Step 1: All-to-All (Q)  -> 重排: 序列切分 -> 头切分
  Card 0 获得 Q'_0 = [B, S, N_h/N_cp, d_h]  (全序列, 头 0~31)
  Card 1 获得 Q'_1 = [B, S, N_h/N_cp, d_h]  (全序列, 头 32~63)

  通信量: 每卡发送 (N_cp-1)/N_cp * B * S_local * N_h * d_h * 2
        = (1/2) * 2 * 4096 * 64 * 128 * 2 = 33,554,432 bytes = 32 MiB

  同理对 K, V 各做一次 All-to-All
  总 All-to-All 通信量(Q+K+V) = 3 * 32 = 96 MiB

Step 2: 每卡独立计算完整 Attention (自己负责的头)
  O'_i = Attn(Q'_i, K'_i, V'_i)  [B, S, N_h_local, d_h]
  Attention 矩阵: [B, N_h_local, S, S]  (完全本地计算, 无需跨卡)

Step 3: All-to-All (O) -> 重排: 头切分 -> 序列切分
  Card 0 获得 O_0 = [B, S_local, N_h, d_h]  (序列段 0, 所有头)
  通信量: 同 Step 1, 32 MiB

Step 4: 过 W_o 投影 (每卡独立, 无通信)总通信量(前向): MiB(3 次 All-to-All for Q,K,V + 1 次 for O)
3.4.4 反向流程
反向传播:

Card i 持有 dO_i [B, S_local, N_h, d_h]

Step 1: All-to-All(dO) -> 头切分模式
  dO'_i = [B, S, N_h_local, d_h]
  通信量: 32 MiB

Step 2: 计算本地 Attention 的梯度
  dQ'_i, dK'_i, dV'_i = Attn_backward(dO'_i, Q'_i, K'_i, V'_i)
  完全本地计算, 无通信

Step 3: All-to-All(dQ), All-to-All(dK), All-to-All(dV) -> 序列切分模式
  通信量: 3 * 32 = 96 MiB

Step 4: W_o 的反向 (每卡独立)总通信量(反向): MiB
总通信量(前向 + 反向): MiB
3.4.5 优化手段
- QKV 融合 All-to-All:将 拼接后一次 All-to-All,减少通信次数从 3 到 1
- 标准 Flash-Attention:每卡持有全序列,可直接用标准 Flash-Attention kernel
3.4.6 三种 CP 变体对比
| 维度 | Ring-Attention | AllGather | Ulysses All-to-All |
|---|---|---|---|
| 通信方式 | P2P 环形 Send-Recv | All-Gather + Reduce-Scatter | All-to-All |
| 前向通信量 () | 256 MiB | 512 MiB | 128 MiB |
| 反向通信量 () | 256 MiB | 512 MiB | 128 MiB |
| 总通信量 | 512 MiB | 1024 MiB | 256 MiB |
| 计算效率 | 中(在线 softmax 开销) | 高(标准 Flash-Attn) | 高(标准 Flash-Attn) |
| 通信 - 计算重叠 | 强(核心设计) | 弱 | 弱 |
| 实现复杂度 | 高 | 低 | 中 |
| 扩展性 | 好(P2P 带宽充分利用) | 中(All-Gather 瓶颈) | 好(All-to-All 对大组友好) |
| 额外显存 | 低 | 高(全序列 K,V) | 中(全序列但部分头) |
4. Expert Parallelism (EP)
4.1 原理
Expert Parallelism(专家并行)是 MoE(Mixture of Experts)模型专用的并行策略。将多个专家(Expert)分布到不同卡上,每张卡只持有部分专家的参数。路由器(Gate/Router)根据输入 token 决定将 token 发送到哪些卡上的专家进行计算。
MoE 层结构:
- Router/Gate:,计算每个 token 对每个专家的分数
- Top-k 选择:每 token 选 k 个专家
- Expert FFN:E 个独立的 SwiGLU MLP,每个
4.2 数学推导
Gate 计算:
其中 ,(每 token 选 k 个专家)。
Expert 计算与加权:
EP 切分: E 个专家分布在 张卡上,每卡持有 个专家。
4.3 切分内容精确描述
- 参数切分:
- Router :不切分,每卡完整持有(所有卡都需要为本地 token 计算路由)
- Expert :按专家切分。卡 i 持有专家 的
- 非 MoE 层(Attention、RMSNorm):不受 EP 影响
- 梯度切分:与参数对应,每个专家的梯度只在持有该专家的卡上计算
- 优化器状态:与参数对应
- 激活值切分(精确到层内位置):
- Router 输入 :每卡持有完整序列(由上游 DP/TP/CP 决定,EP 不额外切分序列维度)
- Router 输出(dispatch 前):每卡为所有 token 计算路由分数
- Expert 输入激活值 :被路由到卡 i 的 token 子集 ,这是一个 不规则的、动态的 激活值分块(不是沿固定维度切分,而是 token 的动态子集)
- Expert 输出激活值:,需合并回原位置
4.4 通信组构成
- EP 通信组: 张卡,持有 E 个专家
- 跨 EP 组的通信通过 All-to-All 实现 token dispatch 和 combine
4.5 通信方式
前向(2 次 All-to-All):
- Dispatch All-to-All:每卡将本地 token 按路由结果发送到目标专家所在卡
- Combine All-to-All:专家计算完成后,将结果按逆路由发回原卡
反向(2 次 All-to-All,与前向对称但方向互换):
- Dispatch 反向 = Combine:将 loss 对 expert 输出的梯度 从原卡发送到对应专家所在卡(与前向 Combine 方向相同,传的是梯度而非激活值)
- Combine 反向 = Dispatch:expert 计算完输入梯度 后,将其按逆路由发回原卡(与前向 Dispatch 方向相同,传的是梯度而非激活值)
4.6 通信数据量计算
Dispatch 阶段(均匀路由假设):
- 每 token 发送 bytes 到目标卡
- 总 token 数 =
- 均匀路由下,每卡发送给 的 dispatch
数值计算():
Combine 阶段: 与 Dispatch 对称,每卡发送 MiB
总通信量(前向): MiB
反向通信量:与前向对称(Dispatch 和 Combine 各一次)
总通信量(前向 + 反向): GiB
4.7 前向与反向流程
前向流程
所有 EP 卡持有: X [B, S, H] (完整序列)
                W_gate [H, E] (完整, 所有卡都有)

Step 1: Router 计算 (每卡独立)
  gate_scores = softmax(X @ W_gate)  [B*S, E]
  top_k_indices, top_k_weights = TopK(gate_scores, k=2)  [B*S, 2]

Step 2: Dispatch All-to-All
  每卡根据 top_k_indices 将 token 发送到对应专家所在卡
  通信: All-to-All, 发送 ~448 MiB, 接收 ~448 MiB

  通信后: 卡 i 持有被路由到本地专家的 token 子集 X_i'
  (均匀假设下约 B*S*k/N_ep = 16384*2/8 = 4096 个 token)

Step 3: Expert 计算 (每卡独立)
  卡 i 对本地每个专家 e 计算: Y_e = W_{down}^e @ (SiLU(W_{gate}^e @ X_i'_e) * (W_{up}^e @ X_i'_e))

Step 4: Combine All-to-All (逆路由)
  将专家输出发回原始卡
  通信: All-to-All, 发送 ~448 MiB, 接收 ~448 MiB

  通信后: 每卡持有完整 Y [B, S, H], 按 top_k_weights 加权合并

Step 5: 加权合并 (每卡独立)
  Y_final = sum_e(top_k_weights[e] * Y_e)  逐 token 加权
反向流程
反向传播:

每卡持有 dY [B, S, H]

Step 1: 加权合并的反向
  d(top_k_weights[e] * Y_e) = top_k_weights[e] * dY  (逐 token)
  每卡需对每个 token 的每个被选专家产生 dY_e

Step 2: Combine All-to-All 的反向 = Dispatch All-to-All
  将 dY_e 发送到对应专家所在卡
  通信: All-to-All, ~448 MiB

Step 3: Expert 反向 (每卡独立)
  卡 i 对本地专家计算:
    dW_{gate}^e, dW_{up}^e, dW_{down}^e (参数梯度)
    dX_i'_e (输入梯度)

Step 4: Dispatch All-to-All 的反向 = Combine All-to-All
  将 dX_i'_e 发回原始卡
  通信: All-to-All, ~448 MiB

Step 5: Router 反向
  每卡计算 dW_gate, 累加到梯度

Step 6: EP 组内梯度同步
  dW_gate 在所有 EP 卡上 All-Reduce (因为 W_gate 是复制的)
  专家参数梯度不需 All-Reduce (各卡只持有自己的专家)
4.8 优化手段
- Capacity Factor:限制每个专家处理的 token 数上限 ,防止负载不均
- Token Dropping:超出容量的 token 被丢弃(或通过残差连接直接传递)
- Expert Balancing Loss:添加辅助损失鼓励均匀路由
- Grouped GEMM:将同一卡多个专家的计算合并为一次 Grouped GEMM
- 通信 - 计算重叠:Dispatch 通信可与 Router 计算重叠
- DeepEP/Expert-EP 优化:使用专用 All-to-All kernel 减少小消息延迟
4.9 专家负载均衡
MoE 的核心痛点:Router 可能将大量 token 路由到少数专家(hot expert),导致部分 EP 卡过载而其他卡空闲。这不只是性能问题——训练不稳定、梯度爆炸、专家退化(某些专家永远不被训练)都可能由此引发。
4.9.1 问题根源
Router 计算 ,每个 token 独立选择 top-k 专家。在训练初期 随机初始化,路由分布天然不均匀;训练过程中还可能出现 马太效应——被选中的专家获得更多梯度更新,变得更强,吸引更多 token,形成正反馈。
负载不均的三个层面:
| 层面 | 表现 | 影响 |
|---|---|---|
| 专家级 | 某些专家处理 5x token,某些几乎为 0 | EP 卡计算不均 |
| 卡级 | 持有 hot expert 的卡成为瓶颈 | All-to-All 延迟 |
| 训练级 | Cold expert 不被训练,参数停滞 | 模型质量下降 |
4.9.2 负载均衡 Loss(Auxiliary Loss)
最核心的方法。 添加辅助损失项,鼓励 token 在专家间均匀分布。
Switch Transformer 的负载均衡 Loss:
设 为总 token 数, 为专家数, 为实际路由到专家 的 token 比例, 为 Router 对专家 的平均概率:
- 当路由完全均匀时:(最小值)
- 当路由完全不均匀时: 增大
- 是超参(通常 0.01),过大会影响主任务
直觉: 在均匀分布时最小(柯西 - 施瓦茨不等式),这个 loss 惩罚的是“高概率 + 高选中率”的专家。
GShard 的 z-loss:
额外添加 z-loss 鼓励 logits 的绝对值不要过大,防止 softmax 饱和:
其中 是未归一化的 logits。
4.9.3 容量因子(Capacity Factor)
硬性限制 每个专家处理的 token 数上限,防止极端不均。
其中 是容量因子(通常 1.0-1.5), 是均匀路由下每专家的期望 token 数。
- 超出 的 token 被 丢弃(通过残差连接直接传给下一层,不经过 expert)
- cf=1.0:严格限制,但丢弃率高,信息损失大
- cf=1.5:允许 50% 冗余,丢弃少,但显存增加
- 训练时常从 cf=1.25 退火到 1.0
显存影响: 容量因子直接决定 expert 输入 buffer 大小:
4.9.4 Token Dropping 策略
超出容量的 token 处理方式:
| 策略 | 做法 | 优缺点 |
|---|---|---|
| 直接丢弃 | 超出的 token 不计算 FFN | 最简单,但信息损失 |
| 残差直通 | (跳过该层的 MoE FFN) | 保持信号传播,主流做法 |
| 随机丢弃 | 从超出的 token 中随机选 个 | 减少系统性偏倚 |
| 优先级丢弃 | 按 Router 分数排序,保留高分 token | 低分 token 被丢弃,可能偏倚 |
Megatron-LM 默认使用 残差直通——被丢弃的 token 直接通过 (不经过任何 expert)。
4.9.5 Expert Bias / Router Noise
Router Noise(训练初期): 在 Router logits 上加高斯噪声,鼓励探索:
通常设为 1.0,随训练退火到 0。这防止 Router 早期固化到某些专家。
Expert Bias: 给每个专家添加可学习偏置 ,用于补偿路由不均:
冷专家的 会被梯度推向更大值,自动吸引更多 token。类似于 MaxViT 的“专家拉力”机制。
4.9.6 路由方案对比
| 路由方案 | 均衡机制 | 通信量 | 模型质量 |
|---|---|---|---|
| Top-k 路由 + 负载均衡 Loss | 软约束(Loss 惩罚) | 标准 | 好 |
| Top-k 路由 + 容量因子 | 硬约束(丢弃超限 token) | 降低(有上限) | 中(信息丢失) |
| Expert Choice 路由 | 专家选 token(反向) | 降低(自动均衡) | 中高 |
| Sparse MLP 路由 | Top-1 + 量化 | 最低 | 中 |
| Hash 路由 | 固定哈希函数 | 无(完全确定) | 差 |
Expert Choice 路由(Gale et al. 2023)反转了路由方向:每个专家从所有 token 中选 top- 个,天然保证负载均衡(每个专家恰好处理 个 token)。代价是 token 可能被多个专家处理或被零个处理。
4.9.7 Megatron-LM 的实际做法
Megatron-LM 默认组合使用:
- 负载均衡 Loss()——软约束,鼓励均匀
- 容量因子 ——硬约束,防止极端不均
- 残差直通——超出容量的 token 跳过 MoE 层
- Router Noise 退火——训练初期探索
- z-loss——防止 softmax 饱和
5. Data Parallelism with ZeRO (DP)
5.1 原理
标准 Data Parallelism(DP)中,每张卡持有完整的模型参数、梯度和优化器状态,各自处理不同数据 batch,前向后通过 All-Reduce 同步梯度。
ZeRO(Zero Redundancy Optimizer)逐步切分这些冗余副本:
| 阶段 | 切分内容 | 冗余消除 |
|---|---|---|
| ZeRO-1 | 优化器状态(Adam 的 m, v, master weights) | 优化器状态不再每卡复制 |
| ZeRO-2 | 优化器状态 + 梯度 | 梯度也按卡切分 |
| ZeRO-3 | 优化器状态 + 梯度 + 参数 | 参数也按卡切分(完全无冗余) |
5.2 显存分析
设模型参数量为 ,使用 Adam 优化器,bf16 训练 + fp32 优化器状态。
标准 DP 每卡显存:
- 参数(bf16): bytes
- 梯度(bf16): bytes
- 优化器状态(fp32 m, v + fp32 master weights): bytes
- 总计: bytes
ZeRO-1(切分优化器状态,$N_{dp}$ 卡):
- 参数:(不切分)
- 梯度:(不切分)
- 优化器状态:
- 总计: bytes
ZeRO-2(切分优化器状态 + 梯度):
- 参数:(不切分)
- 梯度:
- 优化器状态:
- 总计: bytes
ZeRO-3(切分优化器状态 + 梯度 + 参数):
- 参数:
- 梯度:
- 优化器状态:
- 总计: bytes
5.3 切分内容精确描述
ZeRO-1
- 切分对象:优化器状态(Adam 的 , master weights)
- 切分维度:按参数维度均匀切分到 张卡
- 不切分:参数(每卡完整)、梯度(每卡完整)
- 激活值:不涉及
- 前向:标准前向传播,无额外通信
- 反向:标准反向计算梯度后,All-Reduce 同步梯度(每卡获得完整梯度),然后各卡用本地那段优化器状态更新本地那段参数副本(注意:参数仍需 All-Reduce 同步更新后的参数)
ZeRO-2
- 切分对象:优化器状态 + 梯度
- 切分维度:按参数维度均匀切分
- 不切分:参数(每卡完整)
- 激活值:不涉及
- 前向:标准前向传播,无额外通信
- 反向:计算梯度后,用 Reduce-Scatter 将梯度按卡切分(每卡只保留自己那段的梯度),然后各卡用本地梯度更新本地优化器状态和参数。更新后,参数需通过 All-Gather 广播给其他卡
ZeRO-3
- 切分对象:优化器状态 + 梯度 + 参数
- 切分维度:按参数维度均匀切分
- 激活值:不直接切分激活值,但参数不完整需按需收集
- 前向:每层计算前,All-Gather 收集当前层完整参数;计算后丢弃(释放显存)
- 反向:每层反向前,All-Gather 收集当前层完整参数;计算梯度后,Reduce-Scatter 将梯度按卡切分;更新本地参数段
5.4 通信量分析
| 阶段 | 前向通信 | 反向通信 | 总通信量 |
|---|---|---|---|
| 标准 DP | 0 | All-Reduce(梯度) = | |
| ZeRO-1 | 0 | All-Reduce(梯度) = | |
| ZeRO-2 | 0 | Reduce-Scatter(梯度) + All-Gather(参数) = | |
| ZeRO-3 | All-Gather(参数) 每层 = | Reduce-Scatter(梯度) + All-Gather(参数) = |
注意:ZeRO-2 和标准 DP 通信量相同(All-Reduce = All-Gather + Reduce-Scatter),只是拆分了时机。ZeRO-3 比标准 DP 多 的前向 All-Gather 通信量。
数值示例(假设模型参数 参数,bf16):
- ZeRO-3 每卡显存: bytes
- :700 GB / 4 = 175 GB/ 卡(仍然很大,需配合其他并行)
- :700 GB / 32 = 21.9 GB/ 卡
- ZeRO-3 前向 All-Gather 通信量: GB(全部参数每层收集一次,总计)
- ZeRO-3 反向通信量: GB
- ZeRO-3 总通信量: GB
5.5 前向与反向流程
ZeRO-1 前向与反向
前向: 标准前向, 每卡用完整参数计算, 无额外通信

反向:
  Step 1: 每卡计算本地梯度 dW (完整)
  Step 2: All-Reduce(dW) -> 每卡获得完整梯度
          通信量: 2 * Psi * 2 = 4*Psi bytes
  Step 3: 每卡用本地优化器状态段更新对应参数段
  Step 4: All-Reduce(更新后的参数) -> 同步参数
          通信量: 2 * Psi * 2 = 4*Psi bytes
ZeRO-2 前向与反向
前向: 标准前向, 每卡用完整参数计算, 无额外通信

反向:
  Step 1: 每卡计算本地梯度 dW (完整)
  Step 2: Reduce-Scatter(dW) -> 每卡只持有自己那段的梯度
          通信量: 2 * Psi * 2 = 4*Psi bytes (等价于 All-Reduce)
  Step 3: 每卡用本地梯度段 + 本地优化器状态段 -> 更新本地参数段
  Step 4: All-Gather(更新后的参数) -> 广播给所有卡
          通信量: 2 * Psi * 2 = 4*Psi bytes
ZeRO-3 前向与反向
前向:
  对每一层 l (从 0 到 L-1):
    Step 1: All-Gather(W_l) -> 收集当前层完整参数
            通信量: 2 * Psi_per_layer * 2 (bf16)
            总计(全部层): 2 * Psi * 2 = 4*Psi bytes
    Step 2: 用完整参数计算前向 (标准计算)
    Step 3: 丢弃完整参数 (释放显存, 只保留本地段)

反向:
  对每一层 l (从 L-1 到 0):
    Step 1: All-Gather(W_l) -> 收集当前层完整参数
            通信量: 2 * Psi_per_layer * 2
    Step 2: 用完整参数计算本地梯度 dW_l
    Step 3: Reduce-Scatter(dW_l) -> 每卡只持有自己那段的梯度
            通信量: 2 * Psi_per_layer * 2
    Step 4: 丢弃完整参数
    Step 5: 每卡用本地梯度段 + 本地优化器状态段 -> 更新本地参数段
5.6 优化手段
- ZeRO-Infinity:将优化器状态 offload 到 CPU/NVMe,进一步降低显存
- ZeRO-R:切分激活值(与 ZeRO-3 的参数切分配合),减少激活值显存
- 预取重叠:在计算当前层时,预取下一层的参数(ZeRO-3)
- 梯度累积:减少 DP 通信频率(每 N 个 micro-batch 通信一次)
- 通信 - 计算重叠:All-Gather 和 Reduce-Scatter 可与计算重叠
- 分层通信:利用 NVLink(节点内)和 InfiniBand(节点间)的层次结构优化
5.7 梯度累积(Gradient Accumulation)
5.7.1 原理
梯度累积是一种通过 多次小 batch 前向 + 反向、累积梯度后统一更新 来模拟大 batch 训练的技术。它解决了显存不足以容纳大 batch 的问题,同时减少 DP 通信频率。
核心流程:
目标全局 batch size = B_global
每步 micro-batch size = B_micro
累积步数 N_acc = B_global / B_micro

for step = 0, 1, ..., N_acc-1:
    前向: loss_i = forward(micro_batch_i)
    反向: grad_i = backward(loss_i)  # 梯度累加到 .grad
    # 不做 All-Reduce, 不更新参数

# 累积 N_acc 步后:
grad_total = sum(grad_0, ..., grad_{N_acc-1})
All-Reduce(grad_total)  # DP 组内同步梯度
grad_total /= N_acc     # 除以累积步数 (平均梯度)
optimizer.step()        # 统一更新参数
optimizer.zero_grad()   # 清零梯度
5.7.2 数学等价性
设全局 batch 为 ,拆为 个 micro-batch 每个 :
两者数学等价(前提:BatchNorm 等跨样本统计的层需特殊处理,但 LLM 用 RMSNorm/LayerNorm 不受影响)。
5.7.3 通信优化
无梯度累积时(每步 All-Reduce):
- 每 step 一次 All-Reduce,通信量 bytes(bf16)
有梯度累积时(每 步 All-Reduce):
- 每 step 一次 All-Reduce,通信量相同但频率降低 倍
- 等效效果:通信占比从
5.7.4 与 PP 的协同
梯度累积与 Pipeline Parallelism 天然协同——PP 本身就使用 micro-batch:
- PP 的 M 个 micro-batch 就是 M 步梯度累积
- PP 中每个 micro-batch 做完反向后,梯度累积在本地
- 所有 micro-batch 完成后,DP 组做一次 All-Reduce
Megatron-LM 的默认做法:
全局 batch = B_global
PP micro-batches = M (由 PP 调度决定)
DP 梯度累积 = N_acc = B_global / (M * B_micro * N_dp)

每个 PP stage 完成所有 M 个 micro-batch 的反向后:
  → DP 组 All-Reduce 梯度
  → optimizer.step()
  → zero_grad()
5.7.5 显存影响
梯度累积 不增加 峰值显存——每次只处理 1 个 micro-batch 的激活值,反向完成后梯度累加到 .grad(已有显存),激活值可释放。
但需注意:
- PP 的 1F1B 调度中,stage 0 最多缓存 份 micro-batch 的激活值
- 梯度累积不减少这个缓存——它影响的是 optimizer 更新频率,不是 PP 激活值缓存
5.7.6 太大的问题
1. 收敛质量下降
梯度累积的数学等价性成立的前提是:loss 在 micro-batch 间是独立同分布的。但 过大时:
- 全局 batch size 膨胀过大
- 大 batch 训练的泛化 gap 增大——模型容易收敛到 sharp minima
- 学习率需要相应放大(线性 / 平方根 scaling rule),但不总能补偿
2. 训练有效速度变慢
- 越大 → optimizer.step() 频率越低 → 参数更新次数减少
- 同样的 wall-clock 时间,梯度更新步数少了 倍
- 虽然每步的 batch 更大、梯度更稳,但 收敛所需的总 token 数可能增加
3. Pipeline Bubble 比例变化
PP 中 micro-batch 数 M 与梯度累积直接相关。越大 bubble 越小:
但 也不能无限大—— 受限于全局 batch size 和显存(stage 0 缓存 份激活值)。
5.7.6 太小的问题
1. 通信占比高——每步都要 All-Reduce,通信没被计算掩盖
2. 显存不够 —— 太小意味着 要大才能达到目标 batch size,激活值显存撑不住
3. PP bubble 大—— 小时 pipeline 利用率低
5.7.7 实际选择
| 因素 | 倾向大的 Nacc | 倾向小的 Nacc |
|---|---|---|
| 显存不够 | ✅ 用小 micro-batch + 大累积 | |
| 通信瓶颈 | ✅ 降低 All-Reduce 频率 | |
| PP bubble | ✅ 增加 micro-batch 数 | |
| 泛化 gap | ✅ 别让全局 batch 太大 | |
| 收敛速度 | ✅ 更频繁更新参数 | |
| BatchNorm 统计 | ✅ 小 batch 统计更准(LLM 用 RMSNorm 不受影响) |
经验值: 大模型训练通常全局 batch 在 4M-8M tokens(如 Llama 2 用 4M tokens/batch),通过 凑出这个数。 一般在 4-32 之间,不是越大越好,而是 刚好够用 ——在显存允许的 下, 取能达到目标全局 batch 的最小值。
6. 综合实例:TP+SP+PP+CP+EP+DP/ZeRO 全并行配置
6.1 模型配置
| 参数 | 值 | 说明 |
|---|---|---|
| 80 | Transformer 层数 | |
| 8192 | hidden size | |
| 64 | 注意力头数 | |
| 128 | 每头维度 | |
| 64 | 专家数 | |
| 2 | 每 token 选 2 个专家 | |
| dtype | bf16 | 2 bytes |
| 架构 | MoE Transformer | 每 4 层有 1 层 MoE,共 20 个 MoE 层,60 个 dense Attention 层 |
6.2 并行配置
| 并行维度 | 度数 | 说明 |
|---|---|---|
| TP | 4 | Tensor Parallel(含 SP=4) |
| PP | 4 | Pipeline Parallel(4 个 stage,每 stage 20 层) |
| CP | 2 | Context Parallel |
| EP | 8 | Expert Parallel(64 专家 / 8 = 8 专家 / 卡) |
| DP | 4 | Data Parallel(ZeRO-3) |
| 总 GPU | 1024 |
6.3 GPU 拓扑与通信组
全局 GPU 编号: rank = f(dp, ep, cp, pp, tp)

通信组:
├── TP 组: 4 张卡 (同一节点内, NVLink 互联)
│   例: rank 0,1,2,3 (dp=0, ep=0, cp=0, pp=0, tp=0~3)
│
├── DP 组: 4 张卡 (跨节点, InfiniBand)
│   例: rank 0, 256, 512, 768 (dp=0~3, ep=0, cp=0, pp=0, tp=0)
│   ZeRO-3 在此组内切分参数 / 梯度 / 优化器状态
│
├── EP 组: 8 张卡 (跨节点)
│   例: rank 0, 32, 64, 96, 128, 160, 192, 224
│   (dp=0, ep=0~7, cp=0, pp=0, tp=0)
│
├── CP 组: 2 张卡
│   例: rank 0, 16 (dp=0, ep=0, cp=0~1, pp=0, tp=0)
│
└── PP 组: 4 张卡 (跨节点)
    例: rank 0, 64, 128, 192 (dp=0, ep=0, cp=0, pp=0~3, tp=0)
6.4 数据准备
每个 DP 卡处理不同的 micro-batch。
- 全局 batch =
- 序列长度
- 每 GPU 实际处理:
经过 TP/SP 切分后,每 GPU 持有的激活值(进入 CP 前):
- SP 区域激活值:(RMSNorm 区域,SP 按 4 切,)
- 但 CP 进一步切分序列:…
重要:SP 和 CP 都切分序列维度。SP 在 TP 组内切分(),CP 在 CP 组内进一步切分。实际每卡序列长度:
但实际实现中 SP 和 CP 的切分方式不同:
- SP:在 RMSNorm 区域切分,在 Attention/MLP 的核心计算区域通过 All-Gather 恢复完整序列
- CP:在整个 Attention 计算期间保持序列切分
这里我们采用 SP 切分后 ,CP 在此基础上进一步切分 。
6.5 前向传播全过程
以下描述一个 micro-batch 从输入到输出的完整前向流程,聚焦于 GPU rank 0(dp=0, ep=0, cp=0, pp=0, tp=0)的视角。
========== 前向传播开始 ==========

--- Stage 0 (Layer 1~20), PP Stage 0 ---

输入: X [B=2, S_local=2048 (SP 后), H=8192]
  实际上 CP 进一步切分: X_cp [B=2, S_cp=1024, H=8192]

对每一层 l (1~20):

  === [1] RMSNorm 前置 ===
  - SP 区域: 每卡持有 [B=2, S_sp=2048, H=8192]
    但 CP 再切: 实际每卡 [B=2, S=1024, H=8192]
  - RMSNorm 在序列维度独立, 各卡独立计算
  - All-Gather(SP 组): 恢复完整序列 [B=2, 2048, 8192]
    通信量: 3 * B * S_sp/N_sp * H * 2 = 3 * 2 * 512 * 8192 * 2 = 50,331,648 bytes = 48 MiB
    (SP All-Gather, 4 张 TP 卡参与)

  === [2] QKV 投影 (TP) ===
  - TP 组内: W_q, W_k, W_v 按列切分, 每卡持有 1/4 的头 (16 个头)
  - 每卡计算: Q_i, K_i, V_i = X @ W_qkv_i  [B=2, 2048, 2048]
    (2048 = 16 头 * 128 维)
  - 无通信 (TP 区域内各卡独立计算自己那份)

  === [3] CP: 序列切分 Attention 计算 ===
  - CP 将 S=2048 切为 2 段, 每卡 S_cp=1024
  - 以 Ulysses 方案为例:

    Step 3a: All-to-All (Q, K, V) [CP 组, 2 张卡]
      Q: [B=2, S_cp=1024, N_h=64, d_h=128] -> [B=2, S=2048, N_h=32, d_h=128]
      通信量: 3 * (1/2) * B * S_cp * N_h * d_h * 2 = 3 * 0.5 * 2 * 1024 * 64 * 128 * 2
             = 3 * 16,777,216 = 50,331,648 bytes = 48 MiB

    Step 3b: Attention 计算 (完全本地)
      O'= softmax(Q' K'^T / sqrt(d_h)) V'  [B=2, S=2048, 32, 128]
      Attention 矩阵: [B=2, 32, 2048, 2048]

    Step 3c: All-to-All (O') [CP 组]
      O': [B=2, S=2048, 32, 128] -> [B=2, S_cp=1024, 64, 128]
      通信量: 16,777,216 bytes = 16 MiB

    CP 总通信量: 48 + 16 = 64 MiB

  === [4] W_o 投影 (TP) ===
  - W_o 按行切分, 每卡计算部分输出
  - Reduce-Scatter(TP 组): 合并 + 切分(SP 模式)
    通信量: B * S_sp * H * 2 = 2 * 2048 * 8192 * 2 = 67,108,864 bytes = 64 MiB
    输出: [B=2, S_sp/N_sp=512, H=8192] (SP 区域的序列切分)

  === [5] 残差连接 ===
  - Y = X + SP 的输出 (需要 All-Gather 恢复完整序列做残差)
  - 或者在 SP 模式下直接在切分状态做残差

  --- 如果是 MoE 层 (每 4 层 1 次) ---

  === [6a] Router 计算 (EP) ===
  - 每卡持有完整 W_gate
  - gate_scores = softmax(X @ W_gate) [B*S_cp_local, E=64]
  - top_k = TopK(gate_scores, k=2) [B*S_cp_local, 2]

  === [6b] Dispatch All-to-All (EP 组, 8 张卡) ===
  - 将 token 按 top_k 发送到对应专家卡
  - 通信量: (7/8) * B * S_cp_local * k * H * 2
          = (7/8) * 2 * 1024 * 2 * 8192 * 2 = 58,720,256 bytes = 56 MiB
  - 接收: 被路由到本地 8 个专家的 token

  === [6c] Expert FFN 计算 ===
  - 卡 i 持有 8 个专家 (64/8)
  - 对每个接收到的 token, 用对应专家计算:
    Y = W_{down}^e @ (SiLU(W_{gate}^e @ X) * (W_{up}^e @ X))
    W_{gate}^e: [H=8192, 4H=32768], W_{up}^e: [H=8192, 4H=32768], W_{down}^e: [4H=32768, H=8192]

  === [6d] Combine All-to-All (EP 组) ===
  - 将结果发回原卡
  - 通信量: 56 MiB
  - 加权合并: Y_final = sum(gate_weight * Y_e)

  --- 如果是 Dense 层 ---

  === [6'] MLP 计算 (TP) ===
  - W_gate 按列切分: 每卡 [H, 4H/4] = [8192, 8192]
  - W_up 按列切分: 每卡 [H, 4H/4] = [8192, 8192]
  - W_down 按行切分: 每卡 [4H/4, H] = [8192, 8192]
  - 前向: Z = (SiLU(X @ W_gate_i) * (X @ W_up_i)) @ W_down_i
  - Reduce-Scatter(TP 组): 合并 + SP 切分
    通信量: B * S_sp * H * 2 = 64 MiB

  === [7] 残差连接 + RMSNorm 后置 ===
  - 类似前述

--- Stage 间通信 (PP) ---

Layer 20 输出 -> P2P Send 到 Stage 1 (Layer 21~40)
  通信量: B * S_sp/N_sp * H * 2 = 2 * 512 * 8192 * 2 = 16,777,216 bytes = 16 MiB
  (SP 切分后的激活值大小)

--- Stage 1~3 (Layer 21~80) ---
  重复上述流程, 每个 stage 处理 20 层

--- 最终输出 ---
  Stage 3 输出 -> Loss 计算 (每卡独立计算)
  Cross-Entropy Loss: 需要 logits [B, S, vocab_size]
  vocab_size 可能很大, 通常也做 TP 切分

========== 前向传播结束 ==========
6.6 反向传播全过程
========== 反向传播开始 ==========

--- Stage 3 (Layer 80~61), 从最后 stage 开始 ---

Loss -> dLoss/dLogits
  每卡计算本地 logits 的梯度

对每一层 l (从 80 到 61):

  === [1] 反向 RMSNorm 后置 ===
  - 各卡独立计算 (序列维度独立)

  === [2] MLP/MoE 反向 ===

  Dense 层:
  - Reduce-Scatter 的反向 = All-Gather(TP 组)
    通信量: 64 MiB
  - 计算 dW_gate, dW_up, dW_down (每卡对自己那份参数的梯度)
  - dX = dZ @ W_down^T (传播给前一层)

  MoE 层:
  - Combine All-to-All 的反向 = Dispatch All-to-All
    通信量: 56 MiB
  - Expert 反向: dW_{gate}^e, dW_{up}^e, dW_{down}^e, dX_i'
  - Dispatch All-to-All 的反向 = Combine All-to-All
    通信量: 56 MiB
  - Router 反向: dW_gate

  === [3] Attention 反向 ===
  - W_o 反向: All-Gather(TP 组) 的反向
    通信量: 64 MiB

  - CP 反向 (Ulysses 方案):
    All-to-All(dO) -> 头切分
      通信量: 16 MiB
    Attention 反向计算 (本地)
    All-to-All(dQ, dK, dV) -> 序列切分
      通信量: 48 MiB

  - QKV 反向: 各卡独立 (TP 区域内)

  === [4] RMSNorm 前置反向 ===
  - All-Gather 的反向 = Reduce-Scatter(TP 组)
    通信量: 48 MiB

--- PP Stage 间反向通信 ---

  P2P Send: dX (梯度) -> Stage 2 (Layer 60~41)
  通信量: 16 MiB

--- Stage 2~0 (Layer 60~1) ---
  重复上述反向流程

--- DP/ZeRO-3 梯度同步 ---

  在所有 PP stage 反向完成后:

  Step 1: 每层的梯度需要 Reduce-Scatter(DP 组)
    通信量(每层): 2 * Psi_per_layer * 2 (bf16)
    总计: 2 * (全部参数) * 2 = 4 * Psi bytes

  Step 2: All-Gather(DP 组) 更新后的参数
    通信量: 2 * Psi * 2 = 4 * Psi bytes

  ZeRO-3 总通信量: 8 * Psi bytes
  (参数量 ~175B params for this model size:
   约 80 * 4 * 8192^2 + MoE params ~ 几百 B 参数)

========== 反向传播结束 ==========
6.7 单层前向 + 反向通信量汇总
以一个 Dense Attention + MLP 层 为例(不含 MoE):
| 通信 | 通信组 | 方式 | 数据量 | 前向 / 反向 |
|---|---|---|---|---|
| SP All-Gather (RMSNorm 前) | TP=4 | All-Gather | 48 MiB | 前向 |
| CP All-to-All (QKV) | CP=2 | All-to-All | 48 MiB | 前向 |
| CP All-to-All (O) | CP=2 | All-to-All | 16 MiB | 前向 |
| TP Reduce-Scatter (W_o) | TP=4 | Reduce-Scatter | 64 MiB | 前向 |
| TP Reduce-Scatter (MLP) | TP=4 | Reduce-Scatter | 64 MiB | 前向 |
| TP All-Gather (MLP 反向) | TP=4 | All-Gather | 64 MiB | 反向 |
| TP All-Gather (W_o 反向) | TP=4 | All-Gather | 64 MiB | 反向 |
| CP All-to-All (dO) | CP=2 | All-to-All | 16 MiB | 反向 |
| CP All-to-All (dQ,dK,dV) | CP=2 | All-to-All | 48 MiB | 反向 |
| SP Reduce-Scatter (RMSNorm 反向) | TP=4 | Reduce-Scatter | 48 MiB | 反向 |
| 单层总计 | 480 MiB |
以一个 MoE 层 为例(替换 MLP 为 MoE):
| 通信 | 通信组 | 方式 | 数据量 | 前向 / 反向 |
|---|---|---|---|---|
| SP All-Gather (RMSNorm 前) | TP=4 | All-Gather | 48 MiB | 前向 |
| CP All-to-All (QKV) | CP=2 | All-to-All | 48 MiB | 前向 |
| CP All-to-All (O) | CP=2 | All-to-All | 16 MiB | 前向 |
| TP Reduce-Scatter (W_o) | TP=4 | Reduce-Scatter | 64 MiB | 前向 |
| EP Dispatch All-to-All | EP=8 | All-to-All | 56 MiB | 前向 |
| EP Combine All-to-All | EP=8 | All-to-All | 56 MiB | 前向 |
| EP Dispatch (反向) | EP=8 | All-to-All | 56 MiB | 反向 |
| EP Combine (反向) | EP=8 | All-to-All | 56 MiB | 反向 |
| CP All-to-All (dO) | CP=2 | All-to-All | 16 MiB | 反向 |
| CP All-to-All (dQ,dK,dV) | CP=2 | All-to-All | 48 MiB | 反向 |
| TP All-Gather (W_o 反向) | TP=4 | All-Gather | 64 MiB | 反向 |
| SP Reduce-Scatter (RMSNorm 反向) | TP=4 | Reduce-Scatter | 48 MiB | 反向 |
| MoE 层总计 | 640 MiB |
6.8 全局通信量估算
前向(全部 80 层):
- 60 个 Dense 层: GiB
- 20 个 MoE 层: GiB
- PP P2P (3 次 stage 间):
- 前向总通信量: GiB
反向(全部 80 层):
- 60 个 Dense 层: GiB
- 20 个 MoE 层: GiB
- PP P2P (3 次):
- 反向总通信量: GiB
ZeRO-3 DP 通信(每次 step):
- All-Gather(参数, 前向): bytes
- Reduce-Scatter(梯度, 反向): bytes
- All-Gather(参数, 反向): bytes
- 总计: bytes
6.9 显存估算
假设模型总参数 (含 MoE 专家参数):
每卡显存(ZeRO-3, ):
- 参数: GB … 需要更多 DP 度数或 TP 分担
实际中 TP=4 也会切分 Attention 和 MLP 参数:
- TP 切分参数量: 约占总参数的 1/2(Attention + Dense MLP)
- TP 后每卡参数:
- ZeRO-3 进一步切分:
- 参数: GB(仍较大)
- 梯度: GB
- 优化器: GB … 需要 offload 或更大 DP
实际中还需要 EP 分担 MoE 参数:
- EP=8 切分了 64 个专家, 每卡 8 个专家
- 专家参数约占总参数的 70%(典型 MoE 模型)
- Dense 参数(30%):
- 每卡专家参数:
最终每卡参数(TP+EP 切分后):
- Dense 部分(TP=4 切): (TP 切走 1/4)
- Expert 部分(EP=8 切):
- 合计每卡:
ZeRO-3 () 切分后:
- 参数: GB
- 梯度: 55 GB
- 优化器: GB
- 激活值(含重计算): GB
- 总计: GB → 需要多节点或进一步优化
6.10 全流程时序图
时间轴 (从左到右) →

Stage 0:  [F1][F2]...[F_m] [B_m]...[B2][B1]
Stage 1:         [F1][F2]...[F_m] [B_m]...[B2][B1]
Stage 2:              [F1]...[F_m] [B_m]...[B1]
Stage 3:                  [F1]...[F_m][B_m]...[B1]
                                     ^
                                     |
                            反向从此开始

其中:
- F_i = 第 i 个 micro-batch 的前向
- B_i = 第 i 个 micro-batch 的反向
- m = micro-batch 数量 (1F1B 调度)

每个 F_i 内部:
  |RN|AG_sp|QKV|A2A_cp|Attn|A2A_cp|Wo|RS_tp|Res|MLP|RS_tp|Res|

每个 B_i 内部:
  |RN_b|AG_tp|MLP_b|RS_tp|Res_b|Wo_b|AG_tp|A2A_cp|Attn_b|A2A_cp|QKV_b|RS_sp|RN_b|

通信标记:
  AG_sp = All-Gather (SP, TP 组)
  RS_tp = Reduce-Scatter (TP 组)
  A2A_cp = All-to-All (CP 组)
  A2A_ep = All-to-All (EP 组, MoE 层)
  P2P_pp = P2P Send-Recv (PP 组)
7. 总结
本文档全面覆盖了 Megatron 框架下五种核心并行策略:
| 并行策略 | 切分对象 | 核心通信 | 前向通信量 | 反向通信量 |
|---|---|---|---|---|
| TP+SP | 参数(按头 / 列 / 行)、激活值(RN 区域按序列) | All-Gather + Reduce-Scatter (TP 组) | 112 MiB/ 层 | 112 MiB/ 层 |
| PP | 层(按层切分) | P2P Send-Recv (PP 组) | 16 MiB/stage | 16 MiB/stage |
| CP (Ring) | 激活值(Attention 的 Q,K,V 按序列) | P2P 环形 (CP 组) | 256 MiB | 256 MiB |
| CP (AllGather) | 同上 | All-Gather + RS (CP 组) | 512 MiB | 512 MiB |
| CP (Ulysses) | 同上 | All-to-All (CP 组) | 128 MiB | 128 MiB |
| EP | 专家参数(按专家) | All-to-All (EP 组) | 896 MiB/MoE 层 | 896 MiB/MoE 层 |
| DP/ZeRO-1 | 优化器状态 | All-Reduce (DP 组) | 0 | |
| DP/ZeRO-2 | 优化器状态 + 梯度 | RS + AG (DP 组) | 0 | |
| DP/ZeRO-3 | 优化器状态 + 梯度 + 参数 | AG + RS (DP 组) | $4\Psi$ |
这些并行策略可以正交组合,通过合理的通信组划分和调度,在 1024+ 卡的规模上实现接近线性的扩展效率。